
 AI 语音识别
(ASR),上传音频或在线录音,识别为文字,可以复制、下载,并保存识别记录。《AI 对话》 的「语音输入」,使用的也是这个能力。目前接入的是:
- DeepSeek:语音识别
- 阿里云百炼:通义千问 Qwen3-ASR-Flash
- 腾讯云:一句话识别
- 百度智能云:短语音识别(标准版)
反过来,把文本合成为音频,可见 《AI 语音生成》 文档。
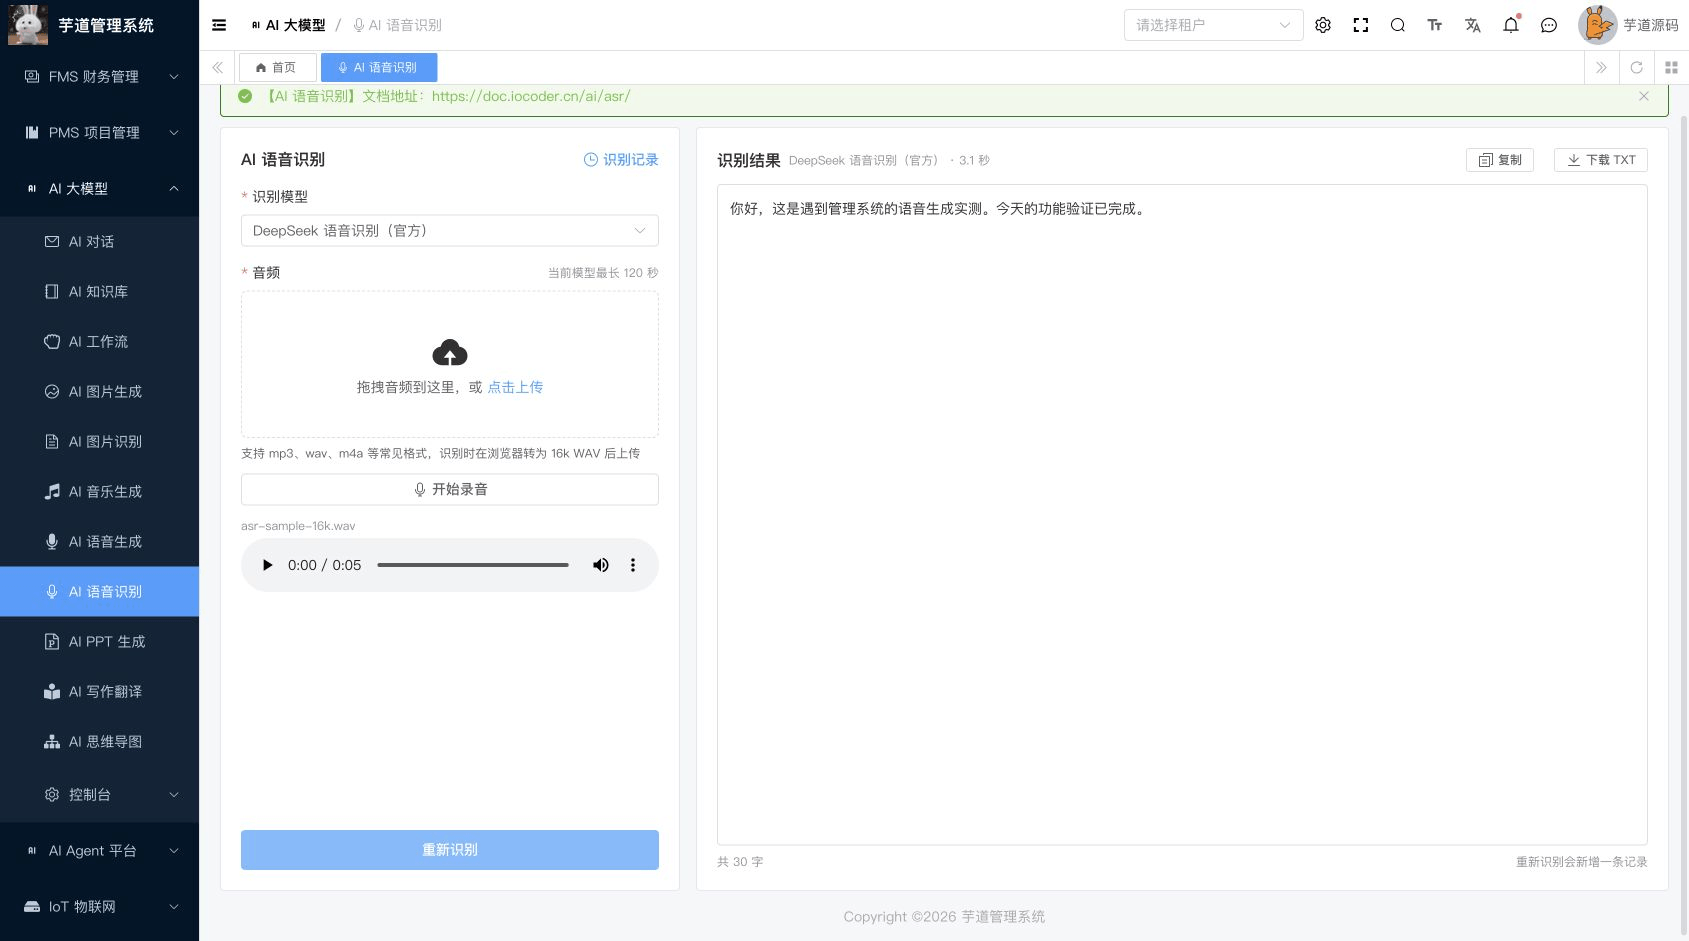
整个功能,涉及到 3 个表:
- 【配置】
ai_api_key:API 密钥表 - 【配置】
ai_model:模型表 - 【数据】
ai_asr:语音识别表
补充说明:
ai_api_key、ai_model 已经在 《功能开启》 讲解,就不重复赘述。
# 1. 前置准备
# 1.1 配置 API 密钥
在 [AI 大模型 -> 控制台 -> API 密钥] 菜单,新增对应平台的密钥:
| 平台 | 所属平台 | 密钥 |
|---|---|---|
| DeepSeek | DeepSeek(DEEPSEEK) | DeepSeek 的 API Key,可以与 DeepSeek 对话共用 |
| 阿里云百炼 | 阿里巴巴(ALIBABA) | 阿里云百炼的 API Key,可以与通义千问对话共用 |
| 腾讯云 | 腾讯(TENCENT) | SecretId|SecretKey,与腾讯混元对话的 API Key 不同 |
| 百度智能云 | 百度(BAIDU) | 百度智能云的 API Key,需要有「短语音识别」的权限 |
腾讯云、百度智能云,需要先在各自的控制台开通「一句话识别」「短语音识别」服务,否则会返回「服务未开通」「鉴权失败」等错误。
同一平台的对话、语音识别使用不同的密钥时,为该平台新建多条密钥,模型配置时选择对应的那一条即可。
# 1.2 配置语音识别模型
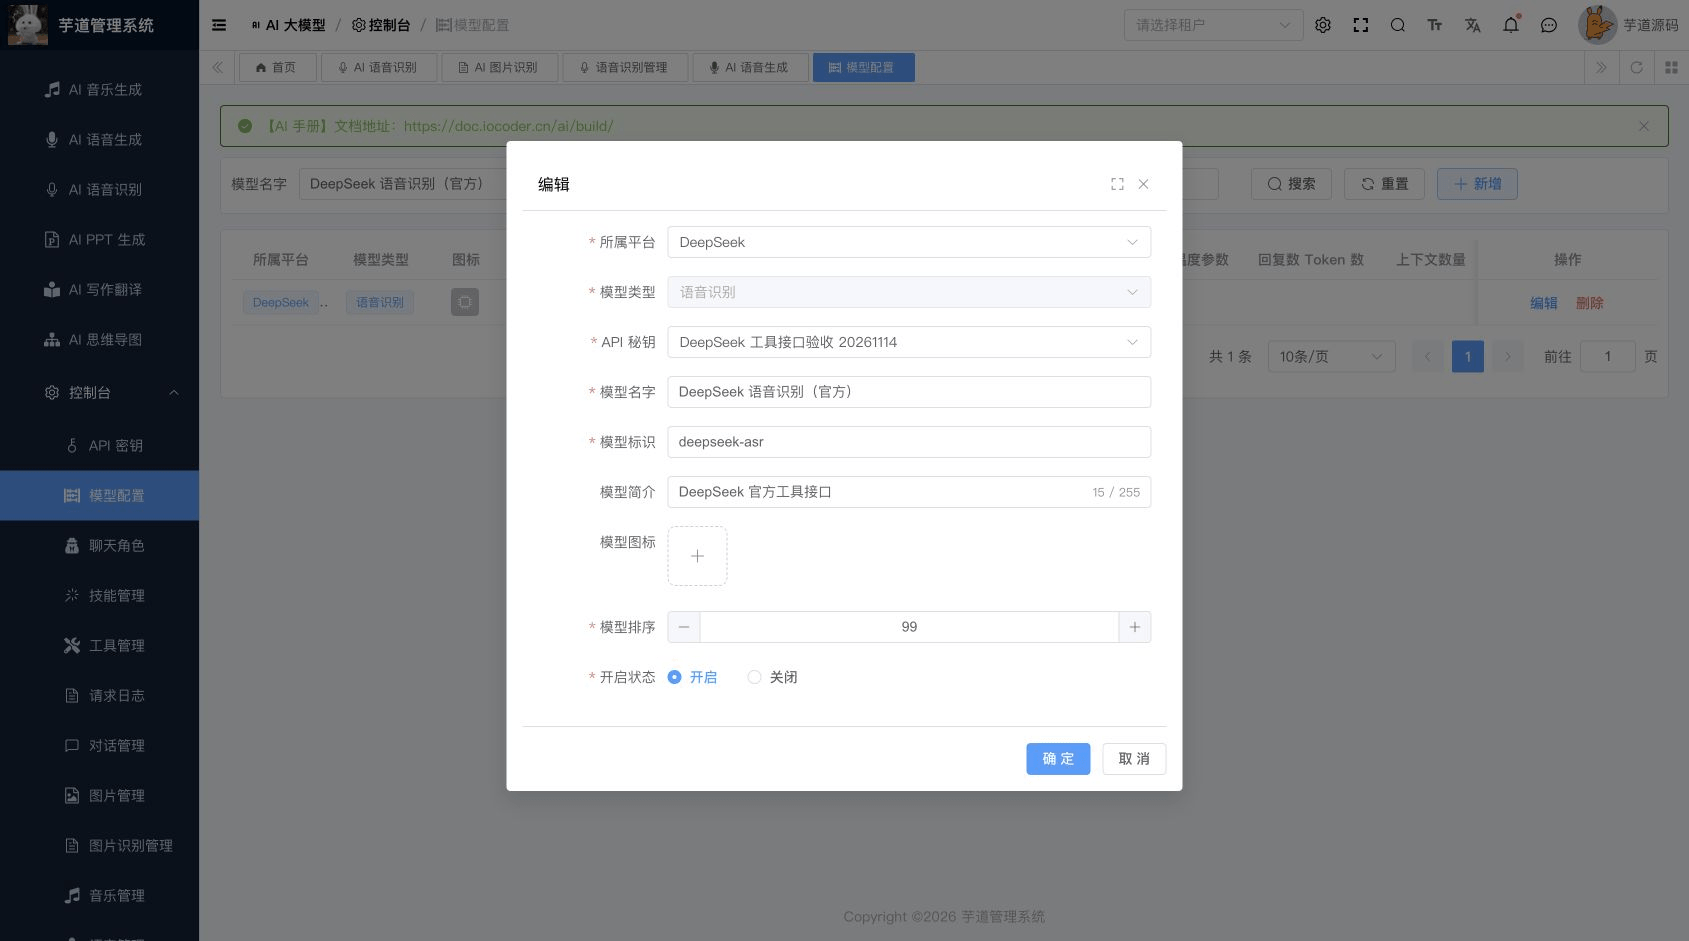
在 [AI 大模型 -> 控制台 -> 模型配置] 菜单,新增语音识别模型:
- 模型类型:选择「语音识别」,对应 AiModelTypeEnum 的 ASR(
type为 9)。它和语音生成的「音频」(VOICE,type为 3)是两种类型,分开配置、分开筛选 - 所属平台:DeepSeek、阿里巴巴、腾讯、百度,其它平台不支持
- API 秘钥:选择同一平台的密钥。密钥的平台与模型的平台不一致时,识别会报错
- 模型标识:见下表
| 平台 | 模型标识 | 最长时长 |
|---|---|---|
| DeepSeek | 自定义,例如说 deepseek-asr(接口没有模型参数) | 120 秒 |
| 阿里云百炼 | qwen3-asr-flash | 180 秒 |
| 腾讯云 | 引擎类型,例如说 16k_zh(中文普通话)、16k_en(英语)等 16k 引擎 | 60 秒 |
| 百度智能云 | 识别模型 dev_pid,例如说 1537(普通话)、1737(英语)、1637(粤语)、1837(四川话) | 60 秒 |
友情提示:
- 前端会把音频统一转为 16kHz 单声道 16 位 PCM 的 WAV 再提交,所以腾讯云只能使用
16k_开头的引擎 - 阿里云的官方上限是 5 分钟、Base64 编码后 10MB,16kHz WAV 按 10MB 计算约 3 分多钟,所以页面限制为 180 秒
- 时长由前端在转换时检查;后端调用服务商之前,只检查格式(WAV)、大小,百度还会检查采样率。其它参数不正确时,由服务商返回错误。调用失败时不会自动重试
# 2. 语音识别
前端对应 [AI 大模型 -> AI 语音识别] 菜单,对应 yudao-ui-admin-vue3 项目的 @/views/ai/asr/index 目录,提供给普通用户使用。
页面左侧是输入区(识别模型、音频、「开始识别」按钮),右侧是识别结果,两者撑满页面高度。
# 2.1 识别音频
① 选择「识别模型」:只列出已启用的「语音识别」模型,同时展示当前模型的最长时长。
② 选择音频,二选一:
- 上传音频:点击、或拖拽音频文件,支持 mp3、wav、m4a 等浏览器可以解码的格式,不超过 50MB
- 在线录音:点击「开始录音」,需要浏览器的麦克风权限;达到当前模型的最长时长后,自动停止
选择后,可以在左侧试听。
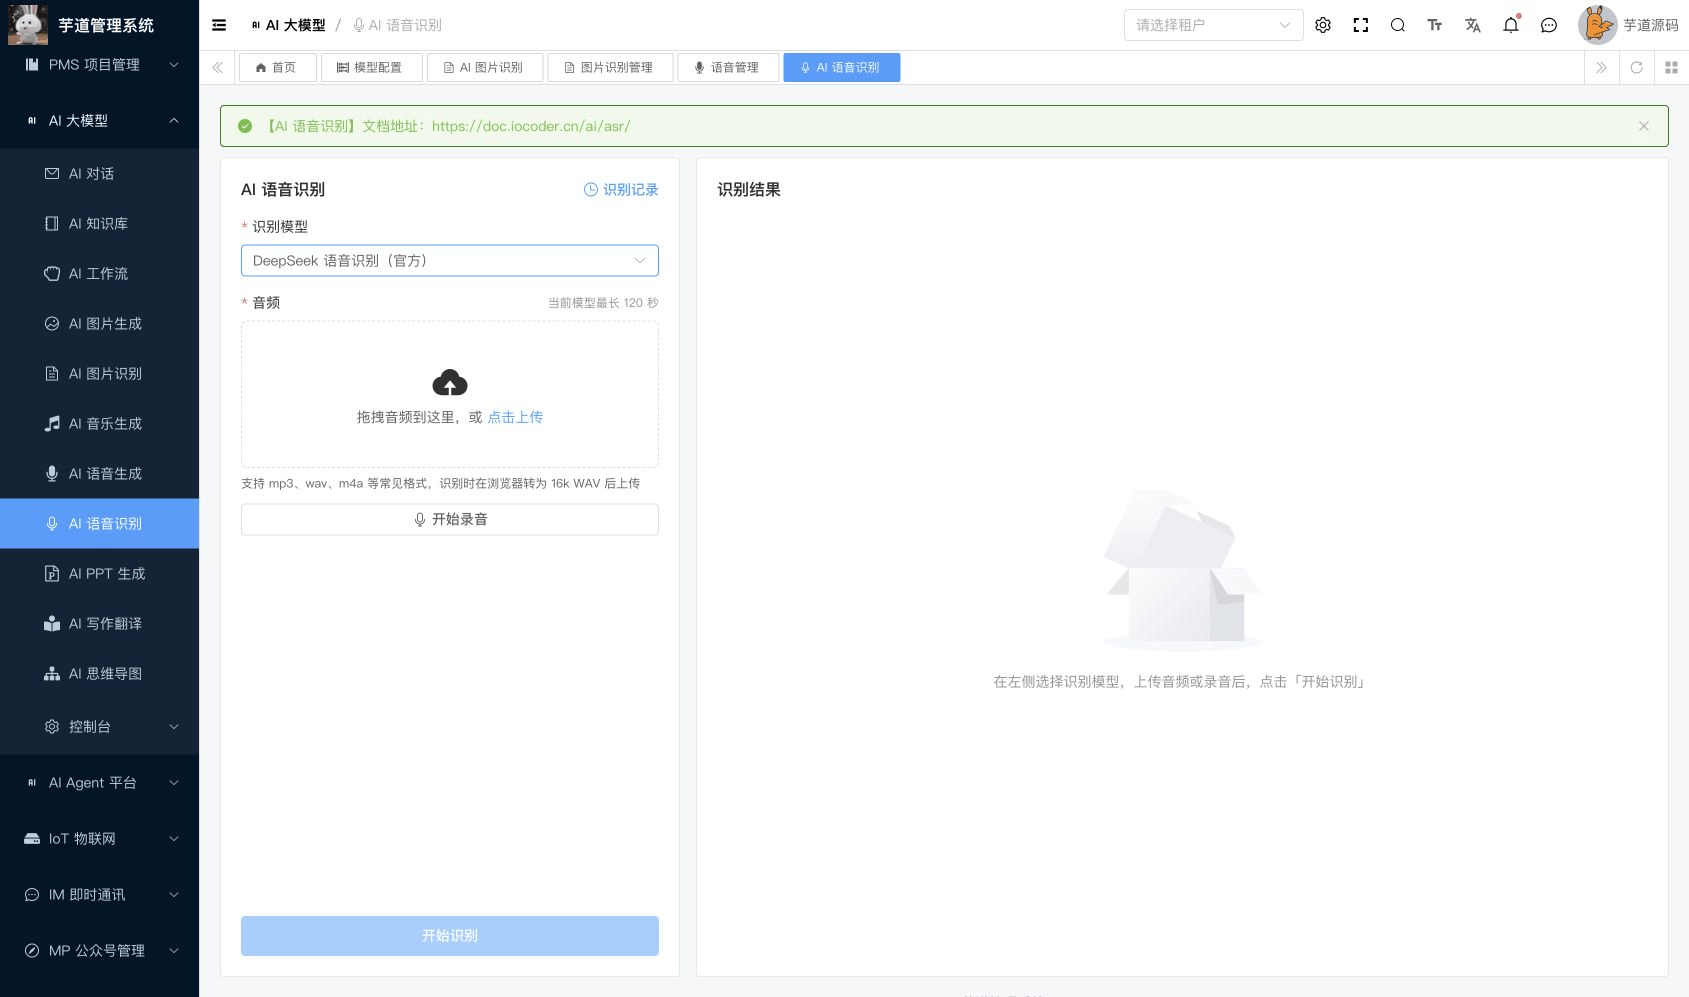
③ 点击左侧底部的「开始识别」:
- 浏览器先把音频解码、重采样为 16kHz 单声道的 WAV,时长超过当前模型的上限时直接提示
- 再通过项目通用的文件上传,保存到文件服务,提交时只传文件地址(
fileUrl)。同一段音频重试时,复用已上传的地址;切换模型后会重新转换、上传 - 后端按地址下载音频(私有存储会使用预签名地址),同步调用识别服务。识别成功、失败,都会新增一条识别记录
# 2.2 识别结果
识别完成后,右侧只读展示识别出的原文,标题栏是识别模型、耗时,以及操作按钮:
- 复制、下载 TXT:复制、下载识别结果
- 重新识别:会新增一条记录,不修改已有的记录
# 2.3 识别记录
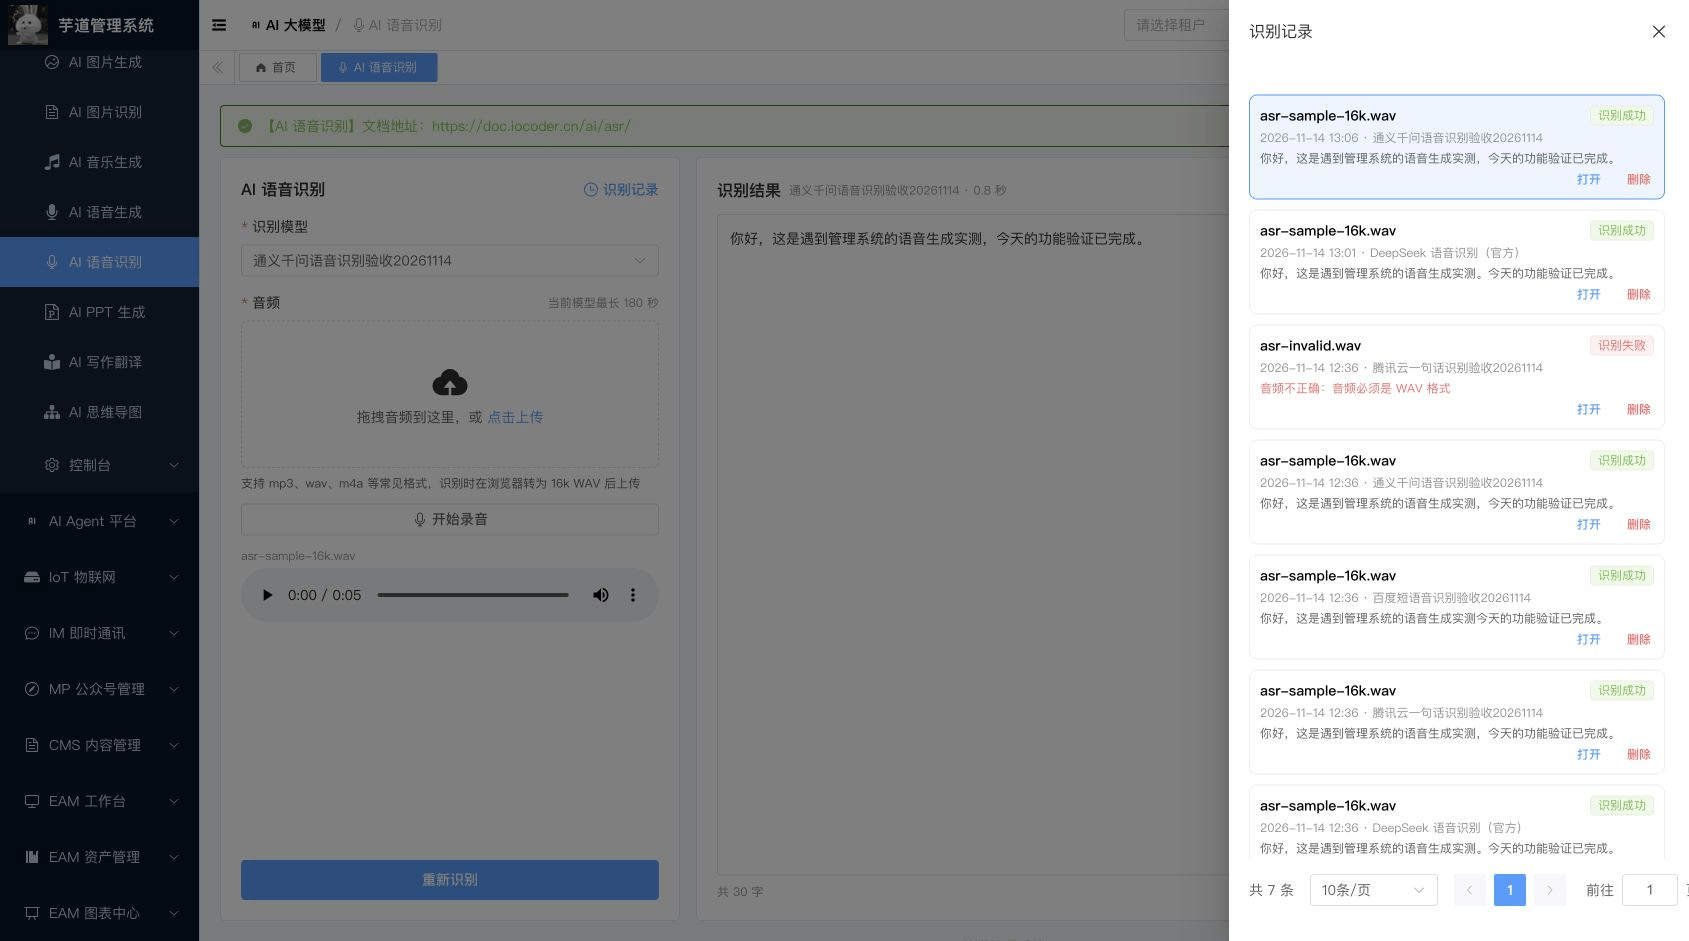
点击左侧标题旁的「识别记录」,查看自己的识别记录,可以重新打开(可以试听当时上传的音频)、删除。删除为逻辑删除,音频文件保留。
打开的记录没有本地音频,重新识别需要重新上传音频、或者录音。
它的后端 HTTP 接口,由 yudao-module-ai 模块的 asr 包的 AiAsrController 实现:
POST /ai/asr/recognize:识别音频中的语音,参数为modelId(语音识别模型编号)、fileUrl(音频文件地址)GET /ai/asr/my-page、GET /ai/asr/get-my:获得【我的】识别记录分页、详情DELETE /ai/asr/delete-my:删除【我的】识别记录
这些接口只操作当前登录用户自己的识别记录。
# 3. AI 对话的语音输入
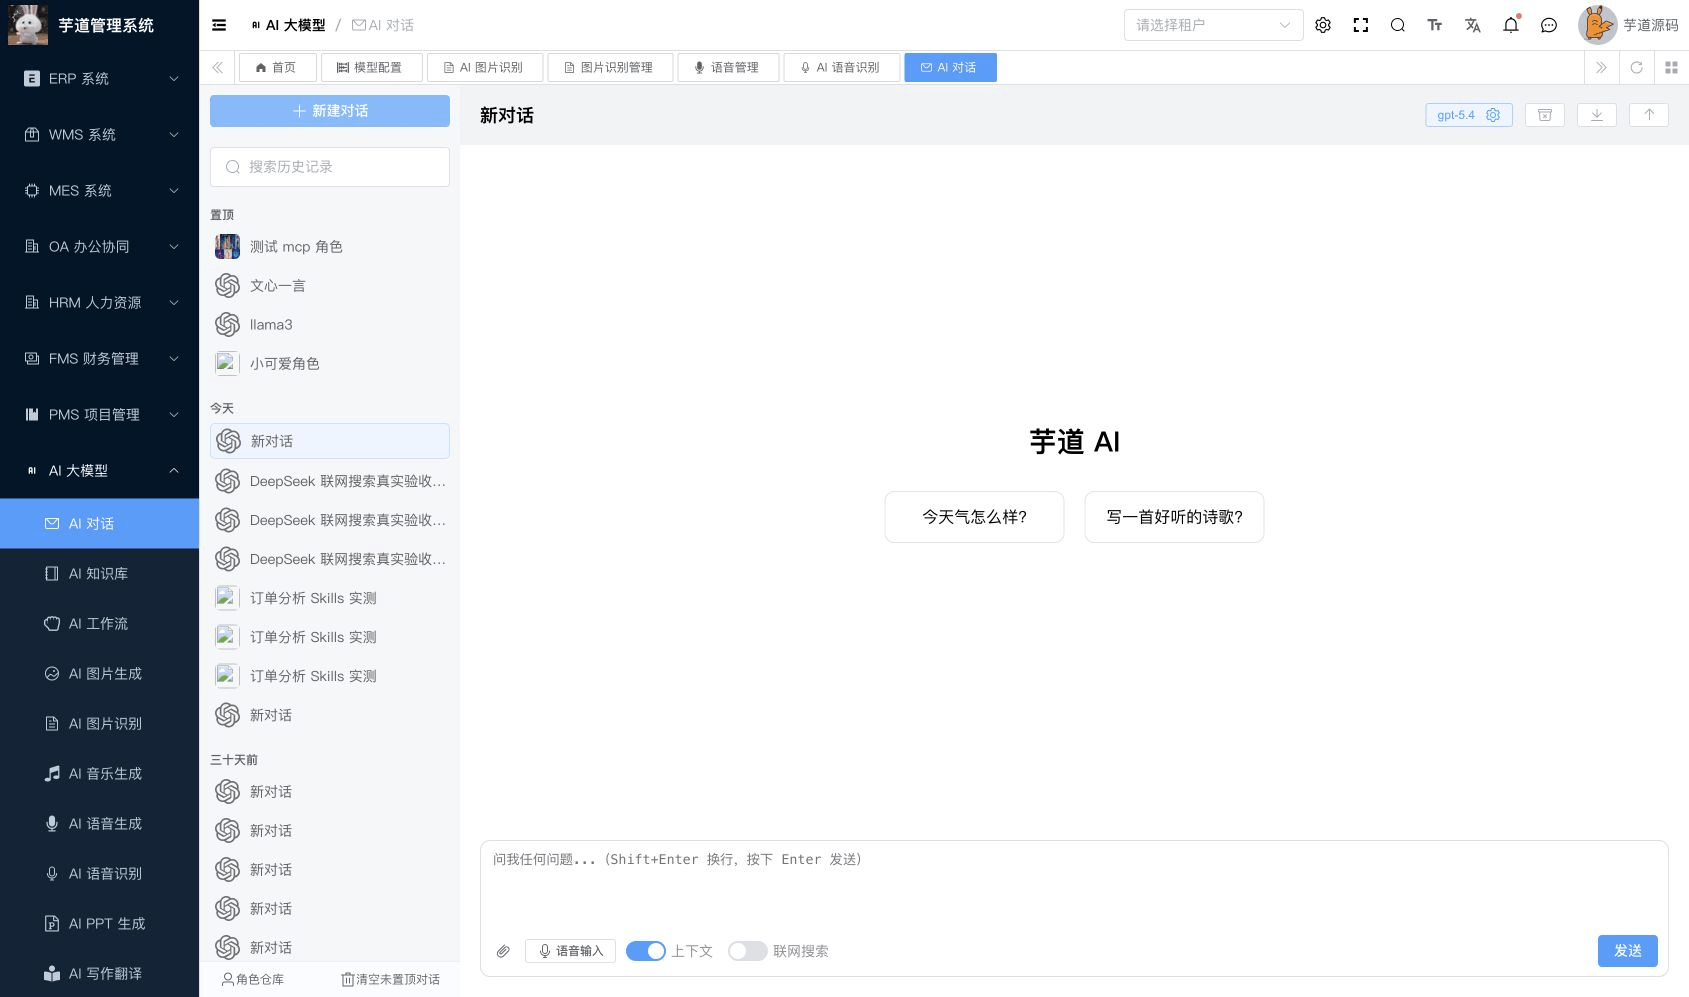
在 [AI 大模型 -> AI 对话] 菜单,存在可用的语音识别模型时,消息发送框的左下角会展示「语音输入」按钮:
- 使用排在第一个的语音识别模型
- 点击开始录音,再次点击停止录音并识别;达到该模型的最长时长后,自动停止
- 录音同样先上传到文件服务,再调用
POST /ai/asr/recognize识别,所以也会新增一条识别记录 - 识别结果追加到输入框,不会自动发送,可以修改后再发送;识别失败时,提示失败原因
# 4. 语音识别管理
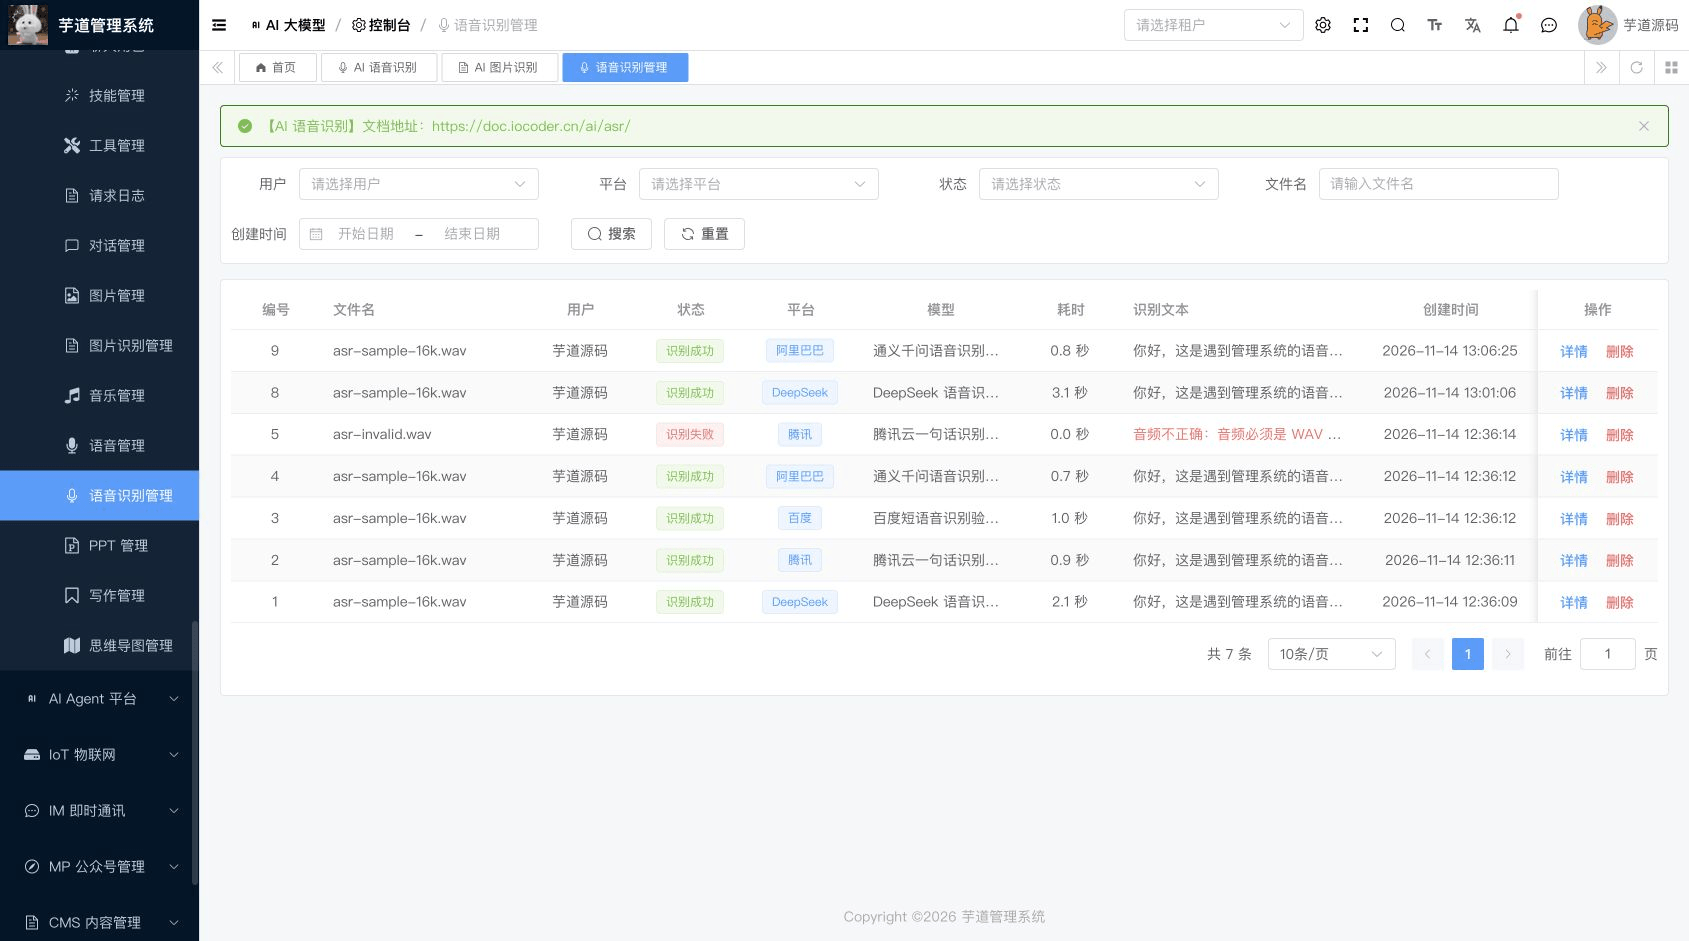
前端对应 [AI 大模型 -> 控制台 -> 语音识别管理] 菜单,对应 yudao-ui-admin-vue3 项目的 @/views/ai/asr/manager 目录,提供给管理员使用,查看所有用户的识别记录:
- 查询:按用户、平台、状态、文件名(模糊匹配)、创建时间筛选
- 详情:试听音频,查看识别原文、识别模型、耗时、失败原因等。管理端只查看,不提供「重新识别」,不会重新调用识别服务
- 删除:逻辑删除,音频文件保留
它的后端 HTTP 接口,同样由 AiAsrController 实现:
GET /ai/asr/page:获得识别记录分页,对应权限ai:asr:queryGET /ai/asr/get:获得识别记录详情,对应权限ai:asr:query;不存在时返回空DELETE /ai/asr/delete:删除识别记录,对应权限ai:asr:delete
# 5. 语音识别表
省略 creator/create_time/updater/update_time/deleted/tenant_id 等通用字段
CREATE TABLE `ai_asr` (
  `id` bigint NOT NULL AUTO_INCREMENT COMMENT '编号',
  `user_id` bigint NOT NULL COMMENT '用户编号',

  `model_id` bigint NOT NULL COMMENT '模型编号',
  `model_name` varchar(64) COLLATE utf8mb4_unicode_ci NOT NULL DEFAULT '' COMMENT '模型名字',
  `platform` varchar(32) COLLATE utf8mb4_unicode_ci NOT NULL COMMENT '平台',
  `model` varchar(255) COLLATE utf8mb4_unicode_ci NOT NULL DEFAULT '' COMMENT '模型标识',

  `file_name` varchar(255) COLLATE utf8mb4_unicode_ci NOT NULL DEFAULT '' COMMENT '音频文件名',
  `audio_url` varchar(1024) COLLATE utf8mb4_unicode_ci NOT NULL COMMENT '音频地址',

  `status` tinyint NOT NULL COMMENT '识别状态:20 成功,30 失败',
  `original_text` mediumtext COLLATE utf8mb4_unicode_ci COMMENT '识别出的原文',
  `error_message` varchar(1024) COLLATE utf8mb4_unicode_ci DEFAULT NULL COMMENT '失败原因',
  `duration` int DEFAULT NULL COMMENT '识别耗时(毫秒)',
  PRIMARY KEY (`id`) USING BTREE,
  KEY `idx_user_id` (`user_id`) USING BTREE
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci COMMENT='AI 语音识别表';
① user_id 字段:对应 system_users 表的 id 字段,表示哪个用户的识别记录。
② model_id、model_name、platform、model 字段:识别时使用的模型,记录当时的快照,之后修改模型配置不影响历史记录。
③ file_name、audio_url 字段:音频的文件名、文件服务中的地址。保存的是前端转换后的 16kHz WAV,也就是实际提交给识别服务的音频。
④ status 字段:识别状态,对应 AiAsrStatusEnum 枚举:20 识别成功、30 识别失败。识别是同步的,识别结束后才写入记录,所以没有「识别中」。模型配置不正确(类型、平台不一致等)时直接报错,不写入记录。
⑤ original_text 字段:识别出的原文,识别后不再修改。
⑥ error_message 字段:失败原因,不包含密钥等敏感信息。duration 字段:识别耗时,单位毫秒。
最最最关键的代码!!!大家可以重点看看!!!
AiAsrServiceImpl 的 #recognizeAsr(...) 方法:校验模型的类型为语音识别、模型与密钥的平台一致后,下载音频,调用 Spring AI 的 TranscriptionModel 同步识别,最后新增一条识别记录。
各平台的调用,由 AiModelFactoryImpl 的 #getOrCreateTranscriptionModel(...) 方法创建:DeepSeekTranscriptionModel、TongYiTranscriptionModel、TencentTranscriptionModel、BaiduTranscriptionModel,统一放在 framework/ai/core/asr 包下。