
 OCR 文字识别
,上传图片后识别其中的文字,识别结果可以修订、复制。目前接入的是:
- 阿里云百炼:Qwen-OCR
- 硅基流动:DeepSeek-OCR
- 百度智能云:通用文字识别(高精度版)
- 腾讯云:通用文字识别(高精度版)
- 火山引擎:通用文字识别
整个功能,涉及到 3 个表:
- 【配置】
ai_api_key:API 密钥表 - 【配置】
ai_model:模型表 - 【识别】
ai_ocr:文字识别表
补充说明:
ai_api_key、ai_model 已经在 《功能开启》 讲解,就不重复赘述。
# 1. 前置准备
# 1.1 配置 API 密钥
在 [AI 大模型 -> 控制台 -> API 密钥] 菜单,新增对应平台的密钥:
| 平台 | 所属平台 | 密钥 |
|---|---|---|
| 阿里云百炼 | 阿里巴巴(ALIBABA) | 阿里云百炼的 API Key,可以与通义千问对话共用 |
| 硅基流动 | 硅基流动(SILICONFLOW) | 硅基流动的 API Key |
| 百度智能云 | 百度(BAIDU) | bce-v3/ 开头的 API Key,或旧版的 APIKey|SecretKey |
| 腾讯云 | 腾讯(TENCENT) | SecretId|SecretKey |
| 火山引擎 | 字节跳动(BYTEDANCE) | AccessKeyId|SecretAccessKey,不是火山方舟的 API Key |
同一平台的对话、文字识别使用不同的密钥时,为该平台新建多条密钥,模型配置时选择对应的那一条即可。
# 1.2 配置文字识别模型
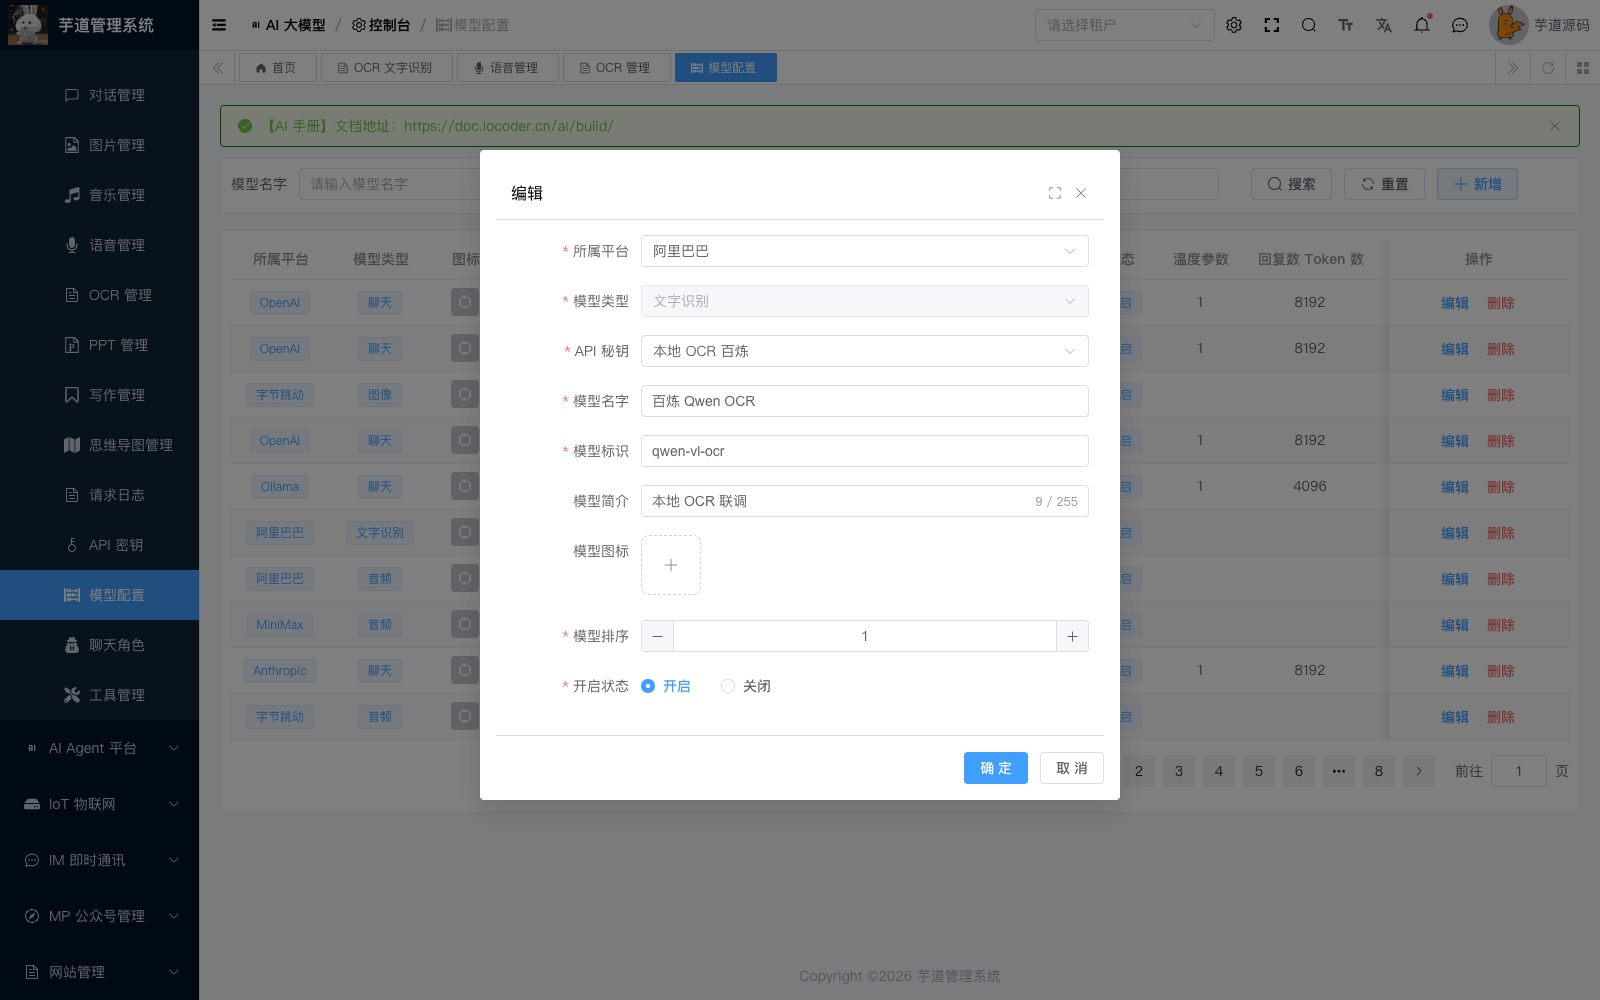
在 [AI 大模型 -> 控制台 -> 模型配置] 菜单,新增文字识别模型:
- 模型类型:选择「文字识别」,对应 AiModelTypeEnum 的 OCR(
type为 8) - 所属平台:阿里巴巴、硅基流动、百度、腾讯、字节跳动,其它平台不支持
- API 秘钥:选择同一平台的密钥。密钥的平台与模型的平台不一致时,识别会报错
- 模型标识:见下表
| 平台 | 模型标识 | 图片格式 | 图片大小 |
|---|---|---|---|
| 阿里云百炼 | qwen-vl-ocr 等 Qwen-OCR 模型 | jpg、png、bmp、tiff、webp、heic | base64 编码后不超过 10MB |
| 硅基流动 | deepseek-ai/DeepSeek-OCR | jpg、png、webp、bmp | base64 编码后不超过 10MB |
| 百度智能云 | accurate_basic | jpg、png、bmp | base64 编码后不超过 10MB |
| 腾讯云 | GeneralAccurateOCR | jpg、png、bmp | base64 编码后不超过 10MB |
| 火山引擎 | OCRNormal | jpg、png、bmp | base64 编码后不超过 8MB |
# 2. 文字识别
前端对应 [AI 大模型 -> OCR 文字识别] 菜单,对应 yudao-ui-admin-vue3 项目的 @/views/ai/ocr/index 目录,提供给普通用户使用。
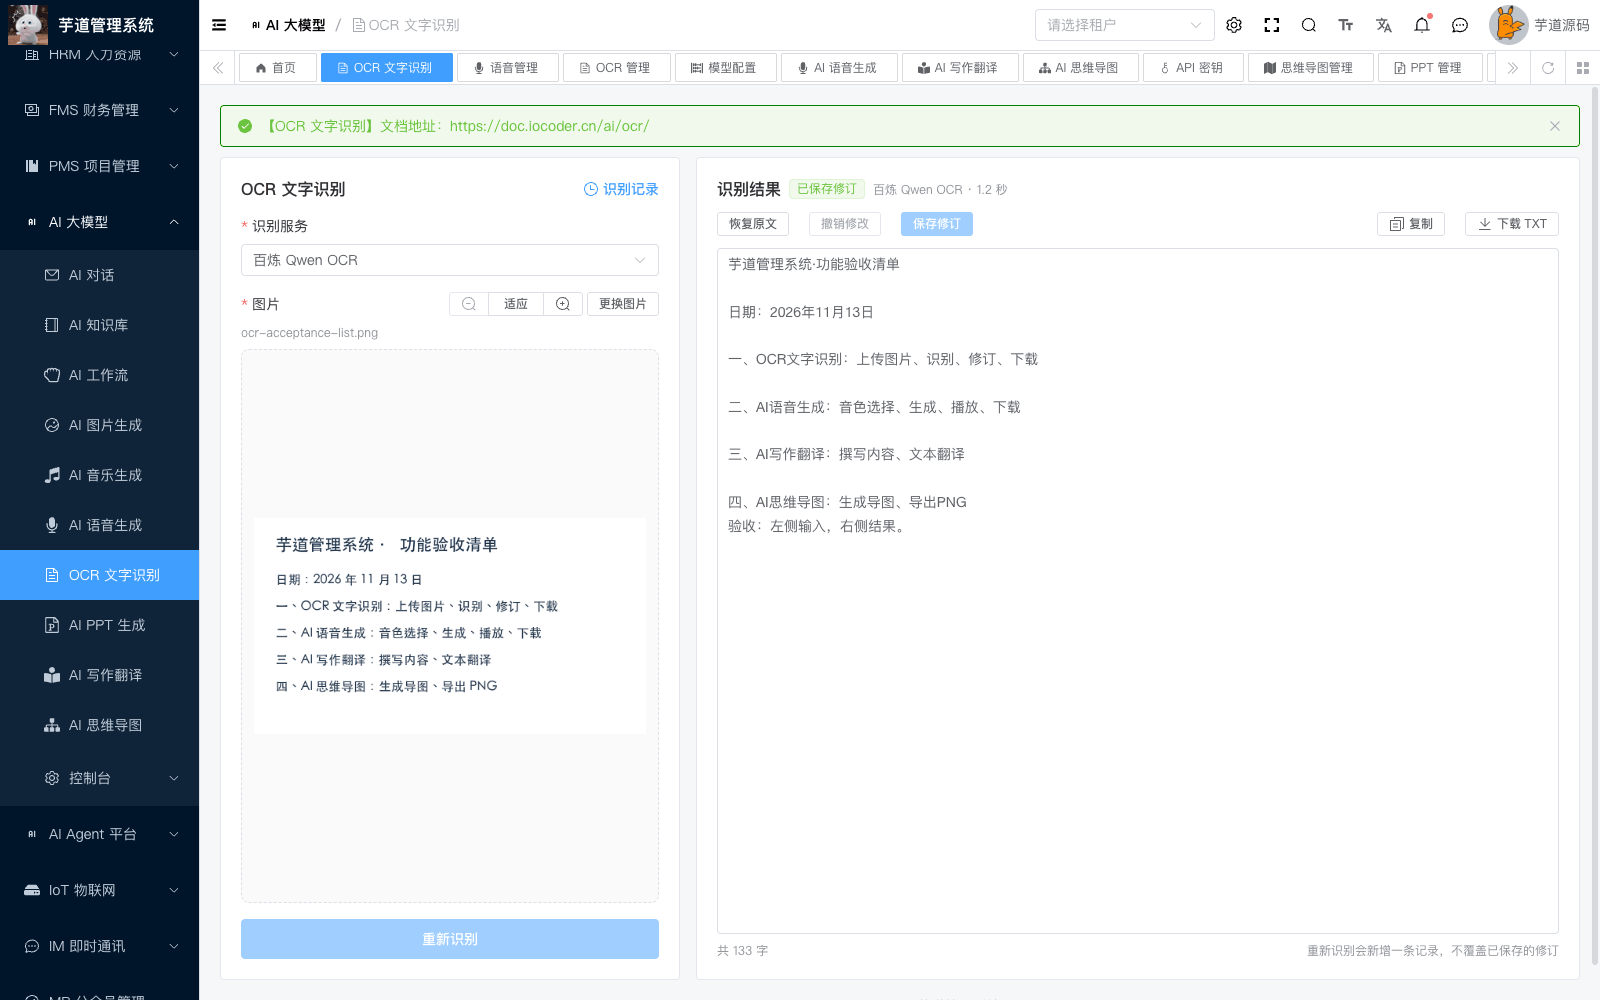
页面左侧是输入区(识别服务、图片、「开始识别」按钮),右侧是识别结果,两者撑满页面高度。
# 2.1 识别图片
① 选择「识别服务」:只列出模型、API 密钥都已启用,且平台支持文字识别的模型。
② 选择图片:在左侧图片区点击选择、拖拽图片,或者直接 Ctrl / ⌘ + V 粘贴截图。图片先通过项目通用的文件上传,保存到文件服务,提交时只传文件地址(fileUrl)。
③ 点击左侧底部的「开始识别」:后端按地址下载图片(私有存储会使用预签名地址),同步调用识别服务。识别成功、失败,都会新增一条识别记录。
# 2.2 修订与复制
识别完成后,左侧图片区可以放大查看原图;右侧展示识别结果,第一行是识别服务、耗时,第二行是操作按钮:
- 修订:直接编辑识别结果,点击「保存修订」后记录为修订文本,原文保留;「恢复原文」「撤销修改」只改编辑区。图片中没有识别到文字时,也可以手动输入
- 复制、下载 TXT:复制、下载当前的识别结果
- 重新识别:会新增一条记录,不覆盖已保存的修订
# 2.3 识别记录
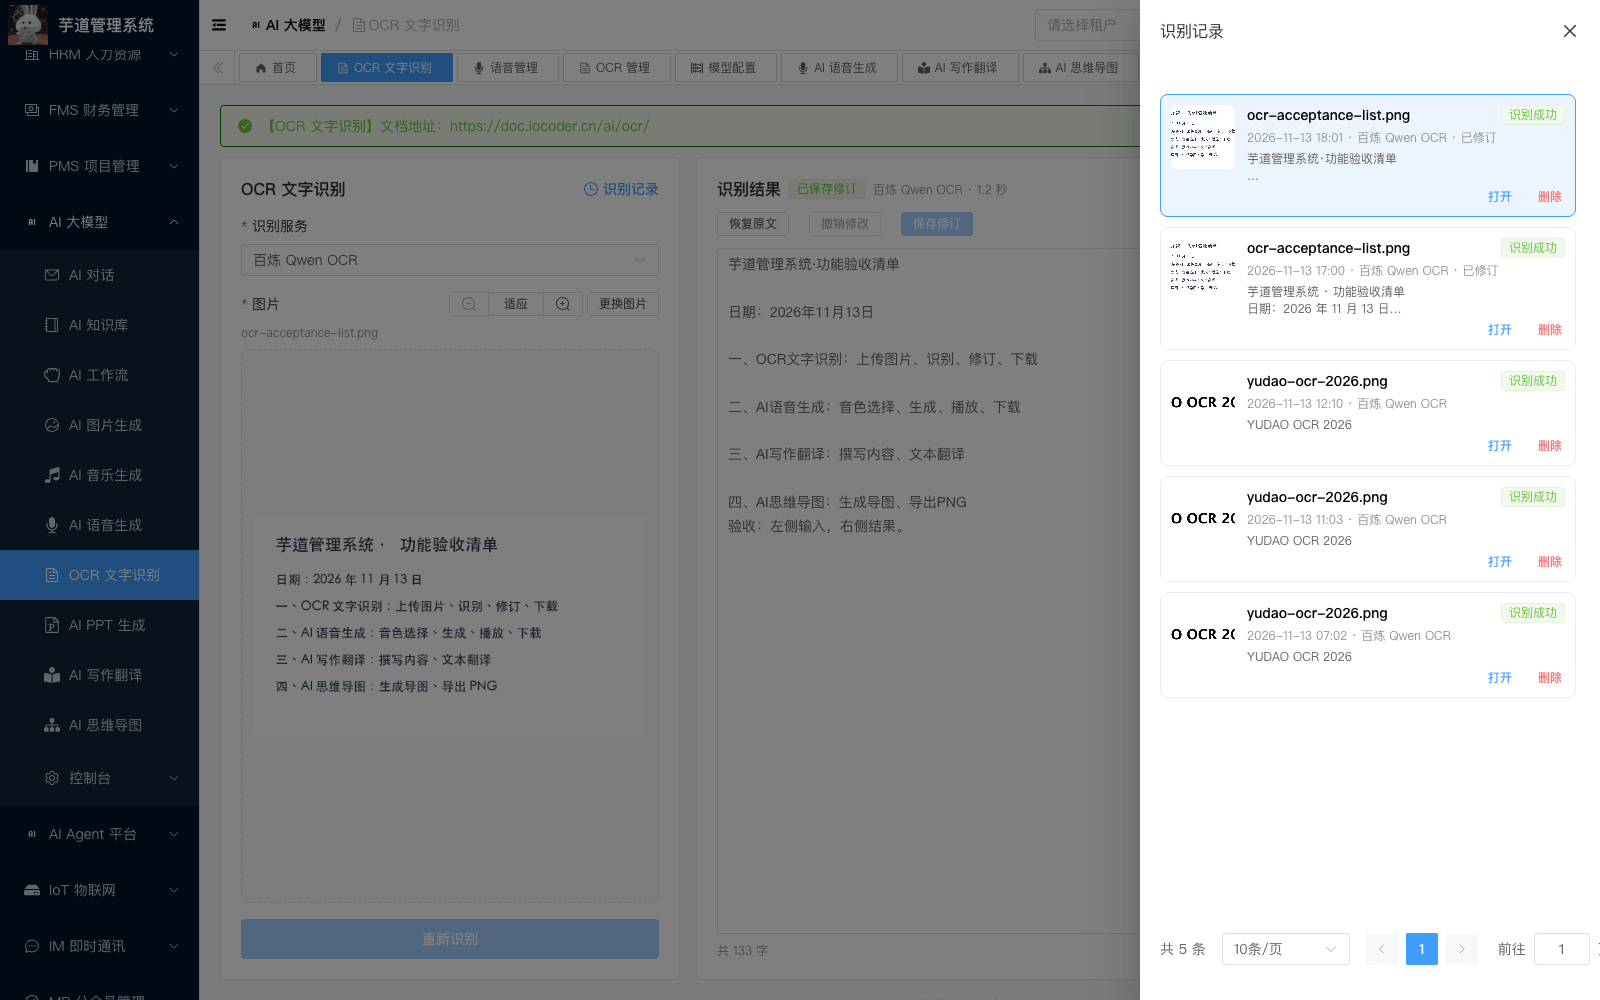
点击左侧标题旁的「识别记录」,查看自己的识别记录,可以重新打开、删除。删除为逻辑删除,图片文件保留。
它的后端 HTTP 接口,由 yudao-module-ai 模块的 ocr 包的 AiOcrController 实现:
GET /ai/ocr/model-list:获得可用的文字识别模型列表,不返回密钥POST /ai/ocr/recognize:识别图片中的文字GET /ai/ocr/my-page、GET /ai/ocr/get-my:获得【我的】识别记录分页、详情PUT /ai/ocr/update-my:保存【我的】识别修订,只能修订识别成功的记录DELETE /ai/ocr/delete-my:删除【我的】识别记录
这些接口只操作当前登录用户自己的识别记录。
# 3. OCR 管理
前端对应 [AI 大模型 -> 控制台 -> OCR 管理] 菜单,对应 yudao-ui-admin-vue3 项目的 @/views/ai/ocr/manager 目录,提供给管理员使用,查看所有用户的识别记录:
- 查询:按用户、平台、状态、文件名(模糊匹配)、创建时间筛选
- 详情:查看图片、识别原文、修订文本、识别服务、耗时、失败原因等。管理端只查看,不提供「重新识别」,不会重新调用识别服务
- 删除:逻辑删除,图片文件保留
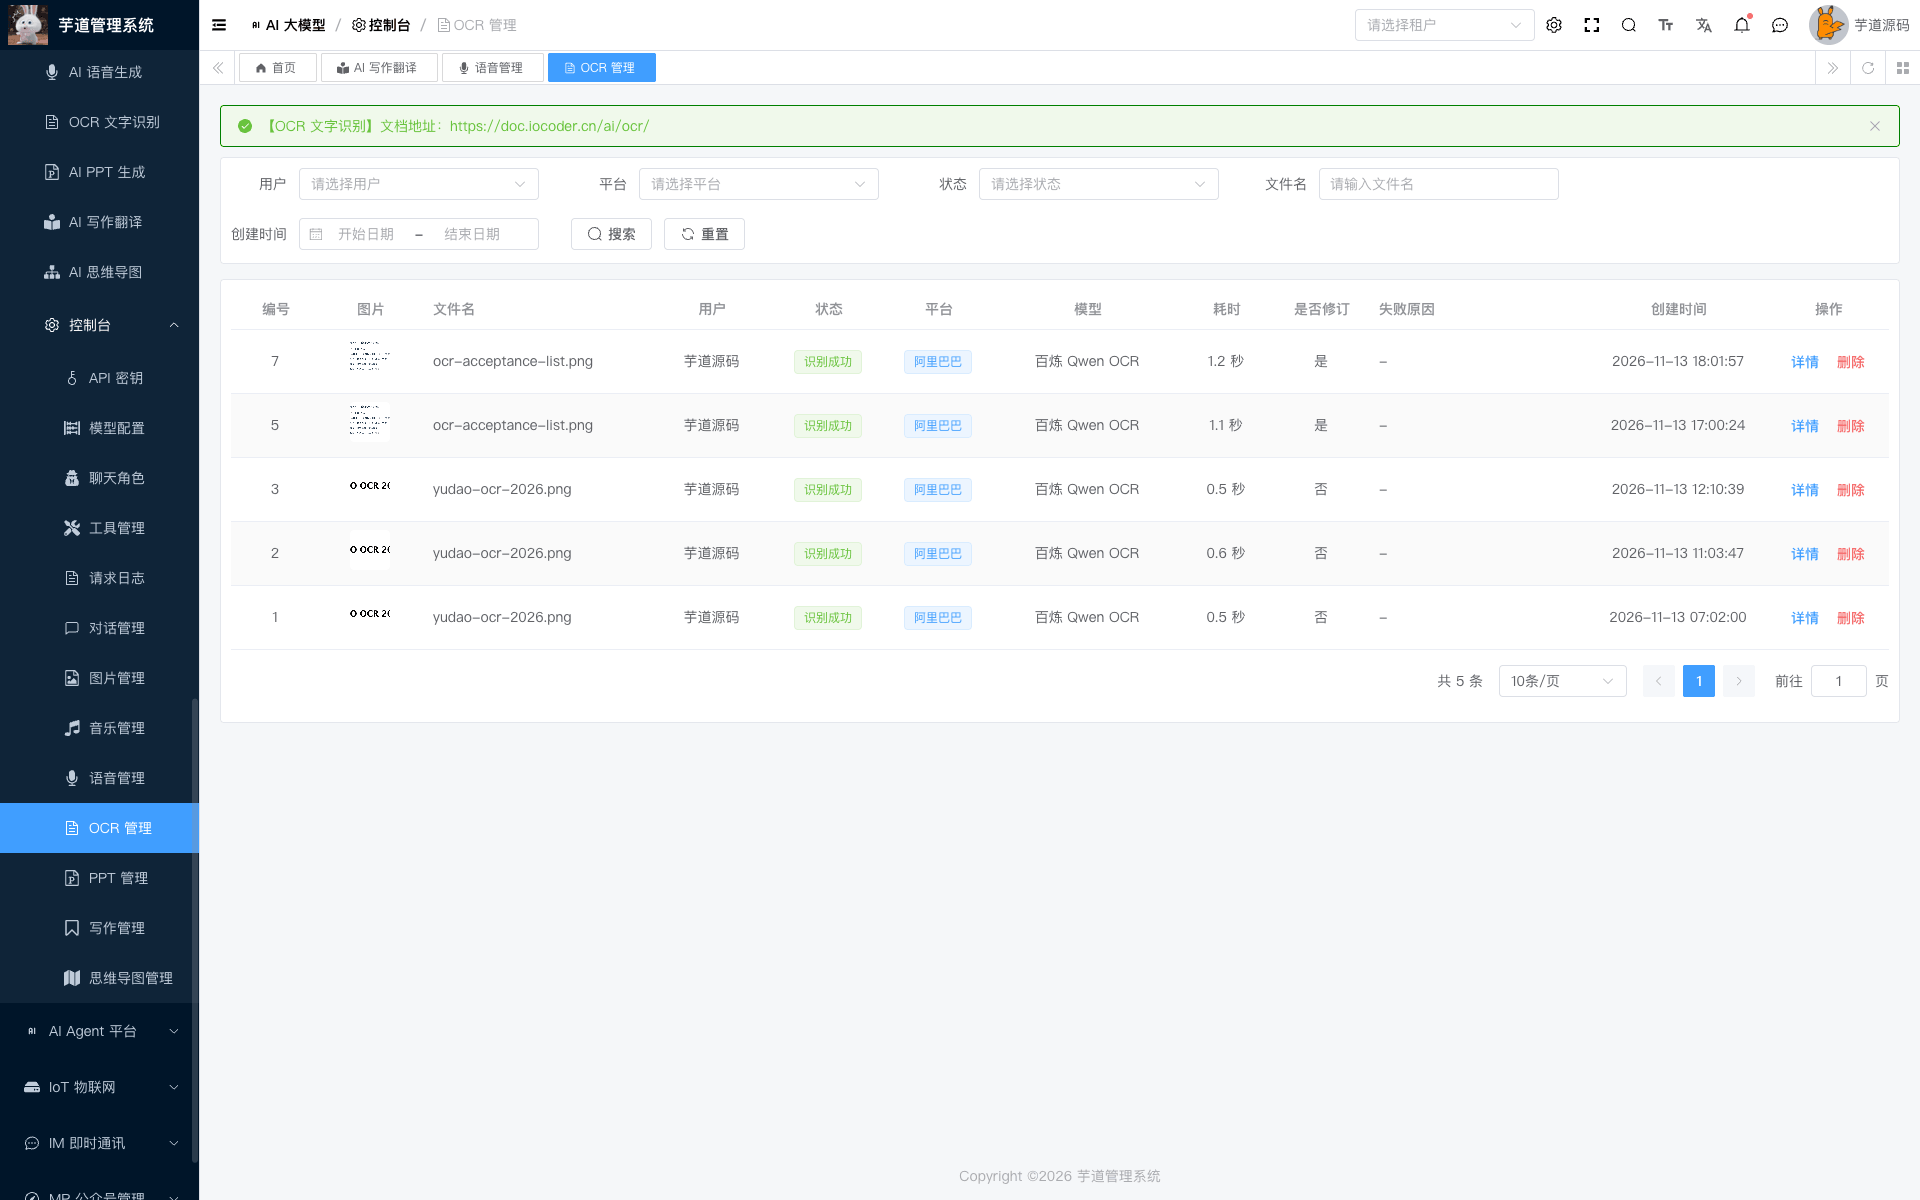
它的后端 HTTP 接口,同样由 AiOcrController 实现:
GET /ai/ocr/page:获得识别记录分页,对应权限ai:ocr:queryGET /ai/ocr/get:获得识别记录详情,对应权限ai:ocr:query;不存在时返回空DELETE /ai/ocr/delete:删除识别记录,对应权限ai:ocr:delete
# 4. 文字识别表
省略 creator/create_time/updater/update_time/deleted/tenant_id 等通用字段
CREATE TABLE `ai_ocr` (
  `id` bigint NOT NULL AUTO_INCREMENT COMMENT '编号',
  `user_id` bigint NOT NULL COMMENT '用户编号',

  `model_id` bigint NOT NULL COMMENT '模型编号',
  `model_name` varchar(64) COLLATE utf8mb4_unicode_ci NOT NULL DEFAULT '' COMMENT '模型名字',
  `platform` varchar(32) COLLATE utf8mb4_unicode_ci NOT NULL COMMENT '平台',
  `model` varchar(255) COLLATE utf8mb4_unicode_ci NOT NULL DEFAULT '' COMMENT '模型标识',

  `file_name` varchar(255) COLLATE utf8mb4_unicode_ci NOT NULL DEFAULT '' COMMENT '图片文件名',
  `image_url` varchar(1024) COLLATE utf8mb4_unicode_ci NOT NULL COMMENT '图片地址',

  `status` tinyint NOT NULL COMMENT '识别状态:20 成功,30 失败',
  `original_text` mediumtext COLLATE utf8mb4_unicode_ci COMMENT '识别出的原文',
  `edited_text` mediumtext COLLATE utf8mb4_unicode_ci COMMENT '修订后的文本:NULL 未修订,空字符串已清空',
  `error_message` varchar(1024) COLLATE utf8mb4_unicode_ci DEFAULT NULL COMMENT '失败原因',
  `duration` int DEFAULT NULL COMMENT '识别耗时(毫秒)',
  PRIMARY KEY (`id`) USING BTREE,
  KEY `idx_user_id` (`user_id`) USING BTREE
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci COMMENT='AI 文字识别表';
① user_id 字段:对应 system_users 表的 id 字段,表示哪个用户的识别记录。
② model_id、model_name、platform、model 字段:识别时使用的模型,记录当时的快照,之后修改模型配置不影响历史记录。
③ file_name、image_url 字段:图片的文件名、文件服务中的地址。
④ status 字段:识别状态,对应 AiOcrStatusEnum 枚举:20 识别成功、30 识别失败。识别是同步的,识别结束后才写入记录,所以没有「识别中」。
⑤ original_text 字段:识别出的原文。edited_text 字段:用户保存的修订文本,为 NULL 表示未修订,空字符串表示已清空,最多 100000 个字符。
⑥ error_message 字段:失败原因,不包含密钥等敏感信息。duration 字段:识别耗时,单位毫秒。
最最最关键的代码!!!大家可以重点看看!!!
AiOcrServiceImpl 的 #recognizeOcr(...) 方法:下载图片、校验模型后,调用 OcrModel 同步识别,最后新增一条识别记录。
各平台的调用,由 AiModelFactoryImpl 的 #getOrCreateOcrModel(...) 方法创建:TongYiOcrModel、SiliconFlowOcrModel、BaiduOcrModel、TencentOcrModel、VolcEngineOcrModel。