
 多数据源(读写分离)、事务
yudao-spring-boot-starter-mybatis (opens new window) 技术组件,除了提供 MyBatis 数据库操作,还提供了如下 2 种功能:
- 数据连接池:基于 Alibaba Druid (opens new window) 实现,额外提供监控的能力。
- 多数据源(读写分离):基于 Dynamic Datasource (opens new window) 实现,支持 Druid 连接池,可集成 Seata (opens new window) 实现分布式事务。
# 1. 数据连接池
友情提示:
如果你未学习过 Druid 数据库连接池,可以后续阅读 《芋道 Spring Boot 数据库连接池入门》 (opens new window) 文章。
<dependency>
    <groupId>com.alibaba</groupId>
    <artifactId>druid-spring-boot-starter</artifactId>
</dependency>
# 1.1 Druid 监控配置
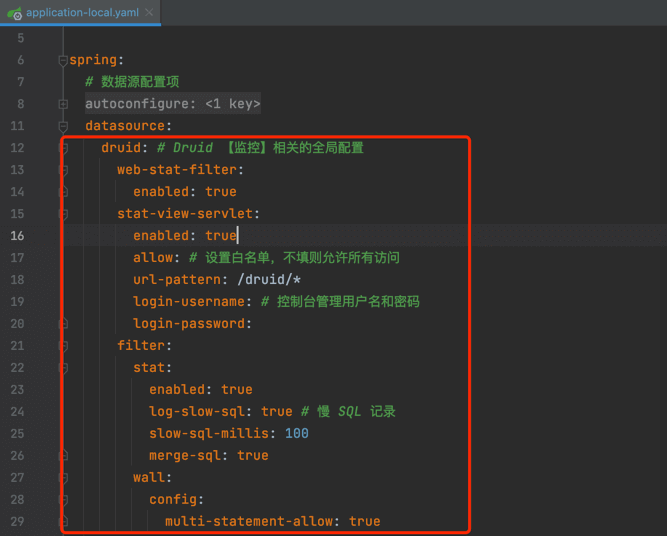
在 application-local.yaml (opens new window) 配置文件中,通过 spring.datasource.druid 配置项,仅仅设置了 Druid 监控相关的配置项目,具体数据库的设置需要使用 Dynamic Datasource 的配置项。如下图所示:
# 1.2 Druid 监控界面
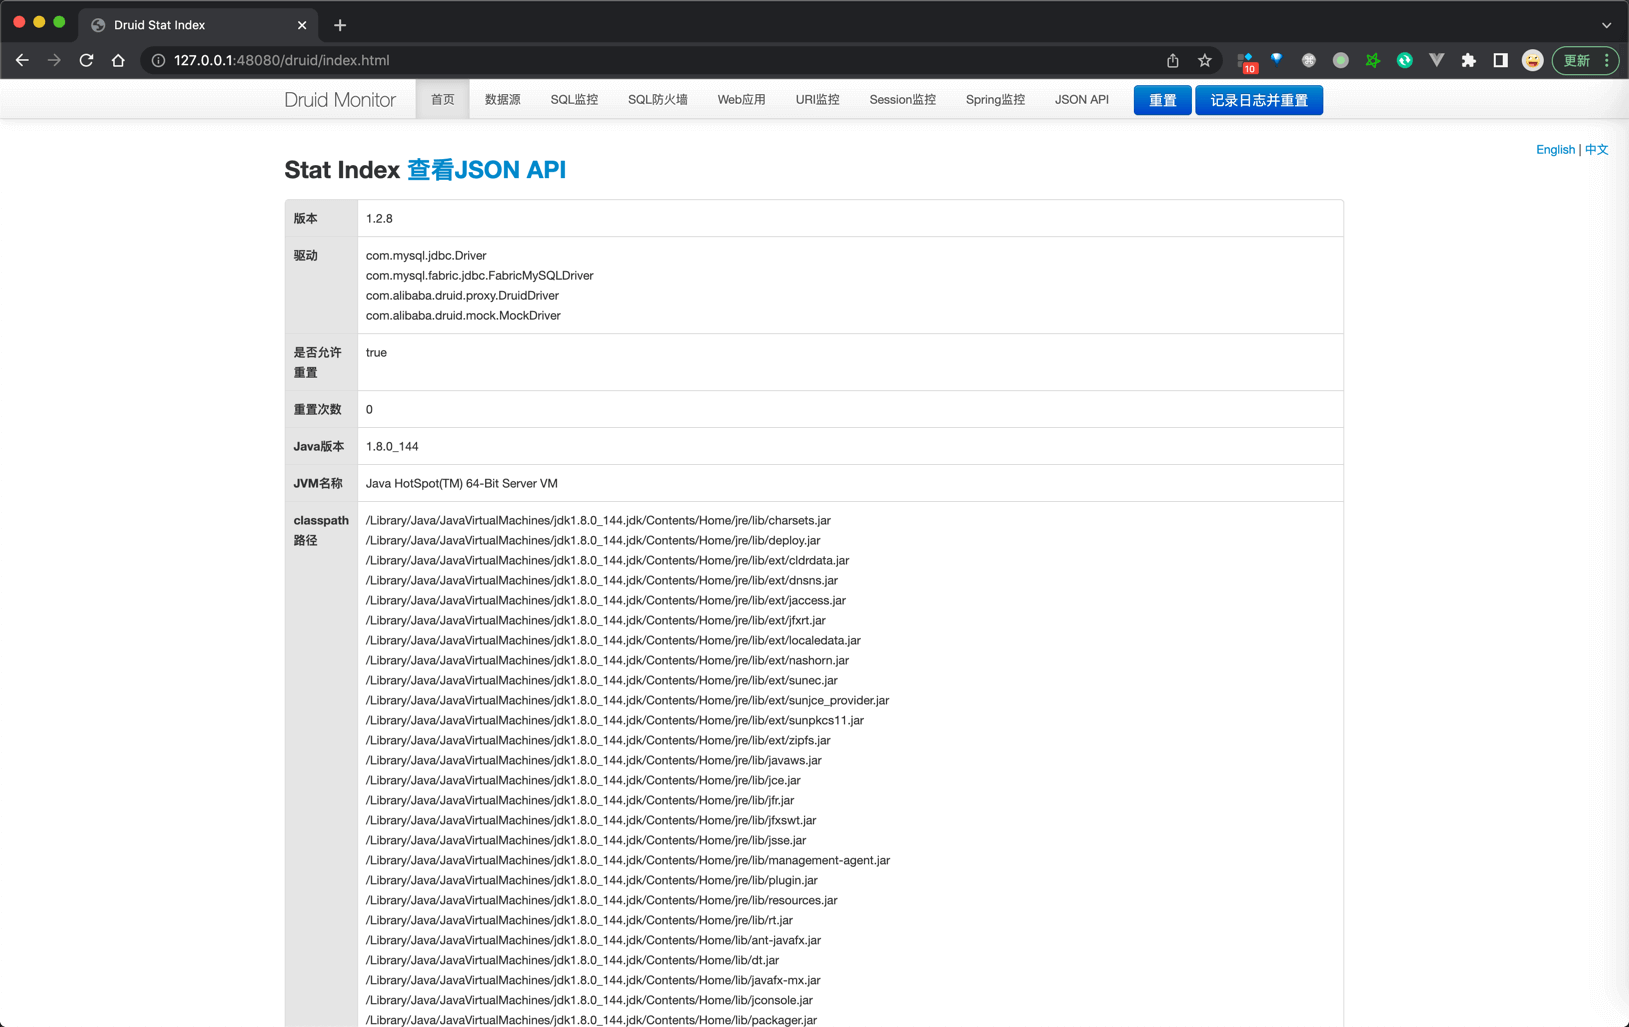
① 访问后端的 /druid/index.html 路径,例如说本地的 http://127.0.0.1:48080/druid/index.html 地址,可以查看到 Druid 监控界面。如下图所示:
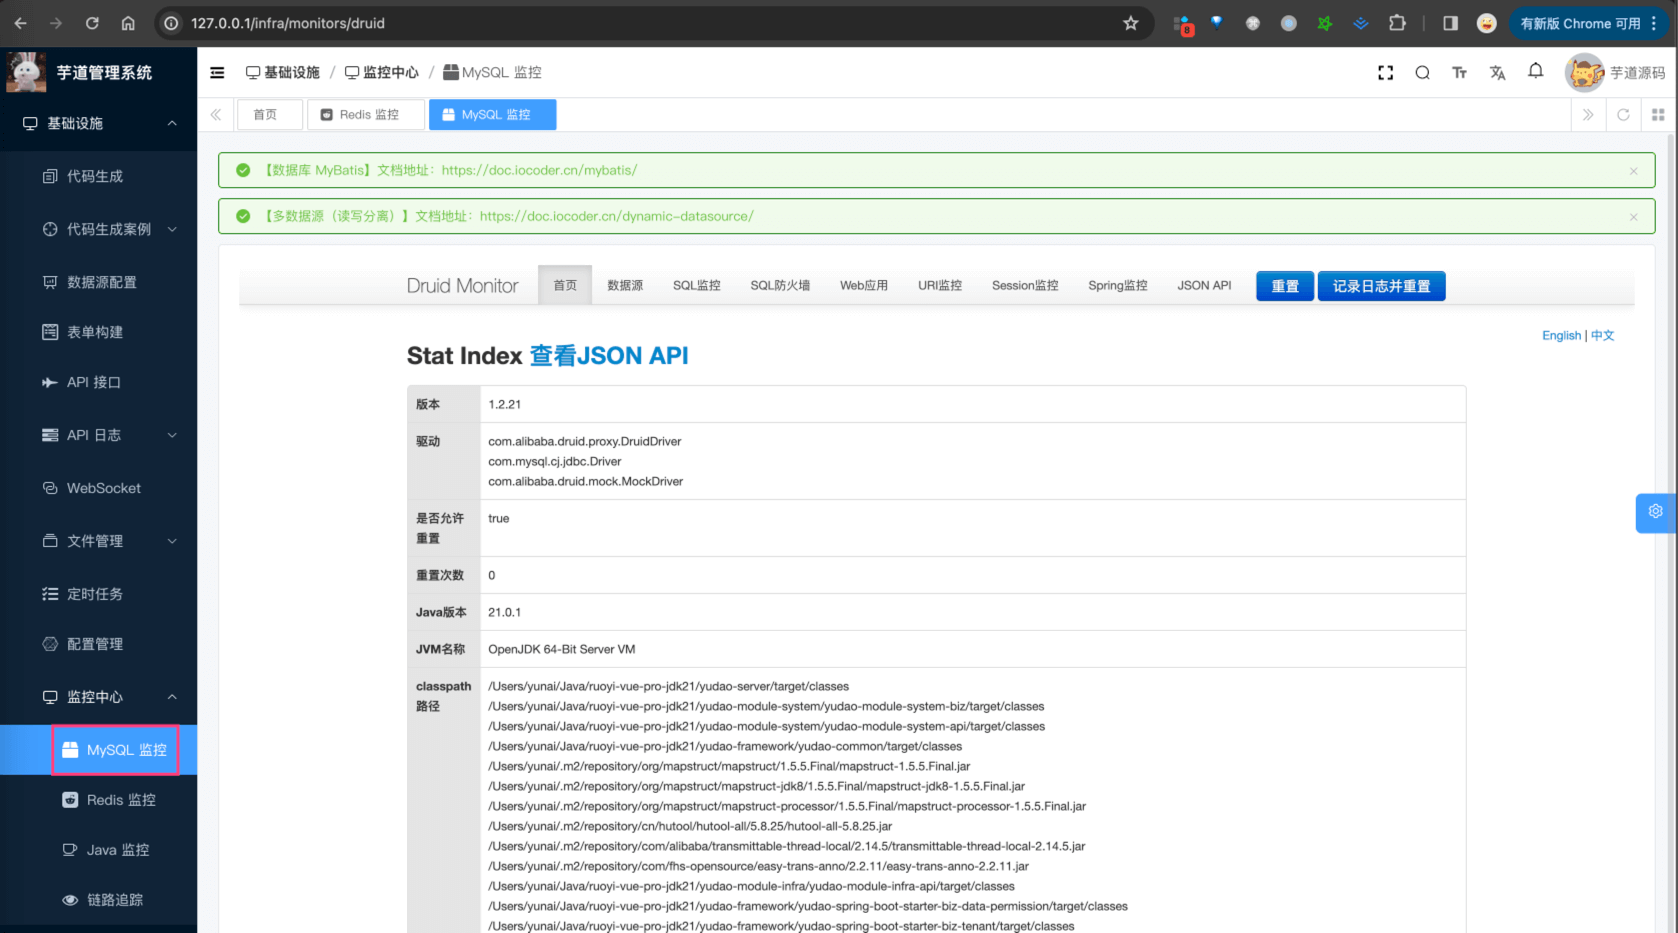
② 访问前端的 [基础设施 -> MySQL 监控] 菜单,也可以查看到 Druid 监控界面。如下图所示:
补充说明:
前端 [基础设施 -> MySQL 监控] 菜单,通过 iframe 内嵌后端的 /druid/index.html 路径。
如果你想自定义地址,可以前往 [基础设置 -> 配置管理] 菜单,设置 key 为 url.druid 配置项。
# 1.3 如何开启登录?
生产环境下,建议 Druid 监控界面开启“安全认证”的功能,避免出现安全事故。
只需要在 spring.datasource.druid.stat-view-servlet 配置项中,设置 login-username 和 login-password 即可。开启后,登录界面如下图所示:

注意:Druid 监控界面,不受管理后台的登录、菜单权限保护
/druid/** 路径在 SecurityConfiguration (opens new window) 中被设置为免登录,只由 Druid 自身的 login-username、login-password 进行认证。所以,管理后台已登录、拥有 [基础设施 -> MySQL 监控] 菜单权限,都不等于 Druid 自身的鉴权;直接访问后端的 /druid/index.html 路径,同样可以打开它。
默认配置中,login-username、login-password 为空(不要求登录),allow 白名单也为空(允许所有访问)。生产环境,建议二选一:
① 不需要 Druid 监控界面时,直接关闭:
spring:
  datasource:
    druid:
      stat-view-servlet:
        enabled: false
② 需要使用时,设置非空、独立的强口令(不要与其它账号共用,也不要使用任何文档、示例中的值),并通过 allow 白名单、防火墙、反向代理等方式,限制只有可信网络可以访问:
spring:
  datasource:
    druid:
      stat-view-servlet:
        enabled: true
        allow: 10.0.0.0/8 # 例如说,只允许内网访问,多个使用逗号分隔
        login-username: ${DRUID_LOGIN_USERNAME}
        login-password: ${DRUID_LOGIN_PASSWORD}
其中,DRUID_LOGIN_USERNAME、DRUID_LOGIN_PASSWORD 通过环境变量等方式注入,例如说(单引号中的内容,需要替换成你自己的用户名、强口令,不要直接使用示例中的值):
export DRUID_LOGIN_USERNAME='<你的用户名>'
export DRUID_LOGIN_PASSWORD='<你的强口令>'
注意,需要确认环境变量已经注入成功:Spring Boot 绑定配置时,无法解析的 ${...} 占位符会被原样当作配置值。
另外,如果经过反向代理访问,Druid 看到的可能是代理的 IP 地址,此时 allow 白名单需要结合代理层的访问限制一起使用。
# 2. 多数据源
友情提示:
如果你未学习过多数据源,可以后续阅读 《芋道 Spring Boot 多数据源(读写分离)入门》 (opens new window) 文章。
<dependency>
    <groupId>com.baomidou</groupId>
    <artifactId>dynamic-datasource-spring-boot-starter</artifactId>
</dependency>
JDK 17 + Spring Boot 3 的版本(master-jdk17 分支),使用的是 dynamic-datasource-spring-boot3-starter 依赖。各分支已经引入对应的 starter,使用项目现有的依赖即可,无需重复添加。
# 2.1 多数据源配置
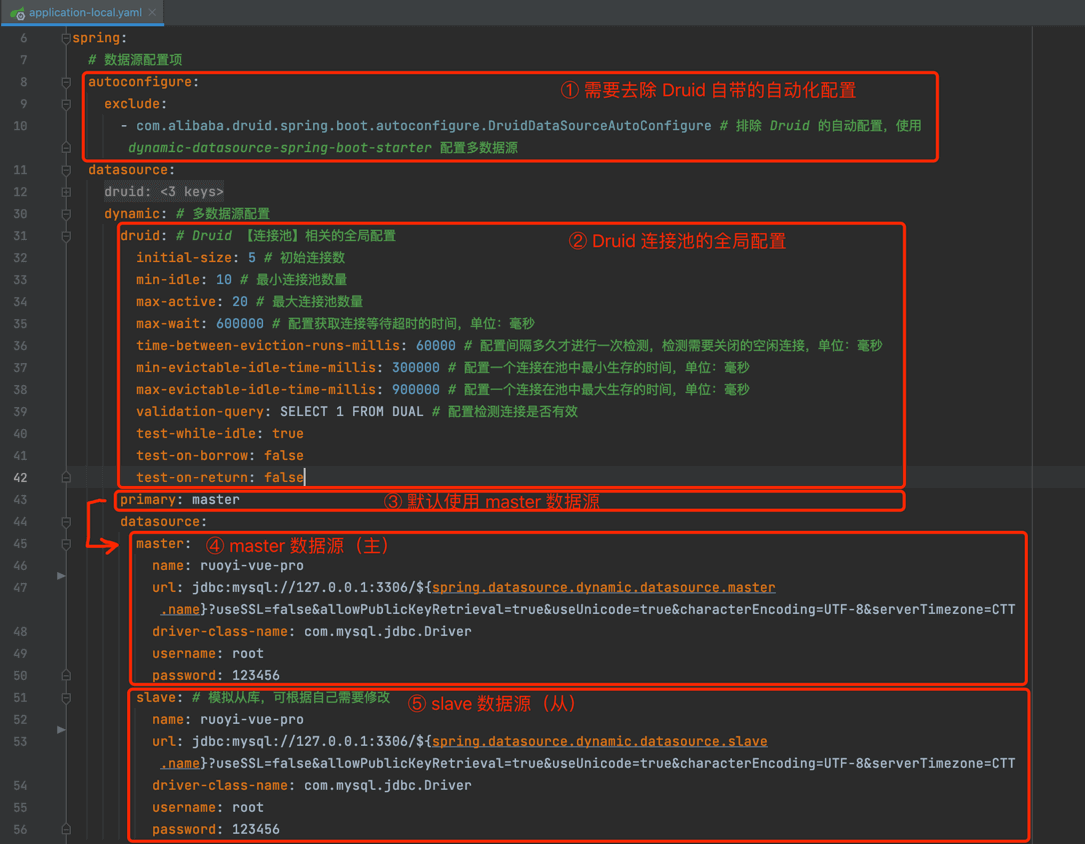
在 application-local.yaml (opens new window) 配置文件中,通过 spring.datasource.dynamic 配置项,配置了 Master-Slave 主从两个数据源。如下图所示:
关于 `slave` 从库:
① 项目里的 slave 只是模拟的从库,默认和 master 指向同一个数据库,方便本地直接启动。
② Dynamic Datasource 只负责“切换”数据源,不会帮你搭建 MySQL 主从复制,也不会自动把 SELECT 语句转发到从库。哪些方法读从库,需要你通过 @Slave 或 @DS("slave") 注解显式指定。
③ 主从复制存在延迟,“刚写入就马上读取”的场景,请继续读主库。从库一般是只读的,不要在切换到从库的方法里写数据。
④ 数据源的名字带下划线时,会按下划线前的部分自动分组。例如说,slave_1、slave_2 会组成 slave 分组,此时 @DS("slave") 会在组内负载均衡。
# 2.2 数据源切换
# 2.2.1 @Master 注解
在方法上添加 @Master (opens new window) 注解,使用名字为 master 的数据源,即使用【主】库,一般适合【写】场景。示例如下图:

由于项目的 spring.datasource.dynamic.primary 为 master,默认使用【主】库,所以无需手动添加 @Master 注解。
# 2.2.2 @Slave 注解
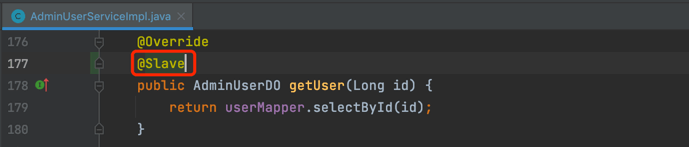
在方法上添加 @Slave (opens new window) 注解,使用名字为 slave 的数据源,即使用【从】库,一般适合【读】场景。示例如下图:
# 2.2.3 @DS 注解
在方法上添加 @DS (opens new window) 注解,使用指定名字的数据源,适合多数据源的情况。示例如下图:
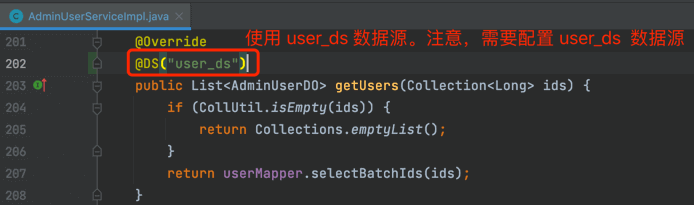
@DS 注解可以添加在类、方法上,方法上的优先级更高;也可以添加在 Mapper 接口上。由于数据源是以“栈”的方式嵌套切换的,调用链中越内层的 @DS 越后生效,执行期间以它为准,执行完后再恢复为外层的数据源。
# 2.2.4 手动切换
除了注解,还可以使用 Dynamic Datasource 提供的 DynamicDataSourceContextHolder 手动切换,适合数据源名字在运行时才能确定的场景。示例代码如下:
DynamicDataSourceContextHolder.push("demo"); // 切换到 demo 数据源
try {
    // 调用 Mapper 逻辑
} finally {
    DynamicDataSourceContextHolder.poll(); // 恢复成切换前的数据源
}
注意事项:
① DynamicDataSourceContextHolder 基于 ThreadLocal 实现,内部是一个栈:push 入栈切换、poll 出栈恢复、peek 查看栈顶(当前数据源名)。@DS 注解底层也是同样的 push + poll,所以两者可以互相嵌套。
② push 之后,必须在 finally 中 poll。否则当前线程会一直停留在该数据源上,而 Web 线程是会被复用的,后续的请求就可能走错库。
③ 恢复时使用 poll,不要使用 clear。clear 会清空整个栈,如果外层方法已经通过 @DS 切换过,会把外层的数据源一起清掉。
④ 手动切换后,如果 try 中调用的 Bean 方法(或 Mapper)自己声明了 @DS("xxx") 注解,那么它执行期间使用的是 xxx 数据源,而不是手动切换的数据源。
⑤ 如果当前已经处于 Spring @Transactional 事务中,手动切换也不会生效,原因见《3.1 @Transactional 注解》小节。
# 2.3 完整示例
下面,我们新增一个可读可写的 demo 业务库,演示【注解】和【手动】两种切换方式。所有的写操作都只针对 demo 库,不会写入 slave 从库。
友情提示:
示例代码放在 yudao-module-infra 模块的 cn.iocoder.yudao.module.infra.dsdemo 包下,验证完成后删除即可。包名需要在 cn.iocoder.yudao.module 下,才能被 Spring 扫描到。
# 2.3.1 第一步,创建数据库
以 MySQL 为例,创建 yudao-demo 数据库,以及 demo_order 示例表:
CREATE DATABASE IF NOT EXISTS `yudao-demo` DEFAULT CHARACTER SET utf8mb4;

CREATE TABLE `yudao-demo`.`demo_order` (
    `id`   BIGINT      NOT NULL AUTO_INCREMENT COMMENT '编号',
    `name` VARCHAR(64) NOT NULL COMMENT '名字',
    PRIMARY KEY (`id`)
) ENGINE = InnoDB COMMENT = '多数据源示例表';
# 2.3.2 第二步,配置数据源
在 application-local.yaml 配置文件中,在已有的 master、slave 的同级,新增 demo 数据源:
spring:
  datasource:
    dynamic:
      primary: master
      strict: true # 可选:找不到数据源时直接抛出异常,方便定位问题
      datasource:
        # master、slave 保持原有配置不变,在它们的同级新增 demo 即可
        demo: # 新增:可读可写的独立业务库
          lazy: true # 开启懒加载,保证启动速度
          url: jdbc:mysql://127.0.0.1:3306/yudao-demo?useSSL=false&serverTimezone=Asia/Shanghai&allowPublicKeyRetrieval=true&nullCatalogMeansCurrent=true&rewriteBatchedStatements=true
          username: root
          password: 123456
关于 `strict` 严格模式:
项目默认没有配置 strict,也就是 false:如果 @DS 指定的数据源找不到,会静默回落到 primary 主库,不会报错,很容易“以为切换了,其实写进了主库”。
设置为 true 后,找不到时会抛出 CannotFindDataSourceException 异常,方便排查。不过开启前,要确认项目中其它 @DS 用到的数据源都已经配置,例如说 IoT 模块的 tdengine 数据源。
# 2.3.3 第三步,编写 DO 和 Mapper
package cn.iocoder.yudao.module.infra.dsdemo;

import cn.iocoder.yudao.framework.tenant.core.aop.TenantIgnore;
import com.baomidou.mybatisplus.annotation.IdType;
import com.baomidou.mybatisplus.annotation.TableId;
import com.baomidou.mybatisplus.annotation.TableName;
import lombok.Data;

/**
 * 多数据源示例 DO
 *
 * @author 芋道源码
 */
@TableName("demo_order")
@TenantIgnore // 示例表没有 tenant_id 字段,所以忽略多租户
@Data
public class DemoOrderDO {

    @TableId(type = IdType.AUTO)
    private Long id;
    private String name;

}
package cn.iocoder.yudao.module.infra.dsdemo;

import cn.iocoder.yudao.framework.mybatis.core.mapper.BaseMapperX;
import org.apache.ibatis.annotations.Mapper;
import org.apache.ibatis.annotations.Select;

/**
 * 多数据源示例 Mapper
 *
 * @author 芋道源码
 */
@Mapper
public interface DemoOrderMapper extends BaseMapperX<DemoOrderDO> {

    @Select("SELECT DATABASE()") // MySQL 写法,用于验证当前连接的是哪个库
    String selectCurrentDatabase();

}
注意,Mapper 上没有添加 @DS 注解,由 Service 决定使用哪个数据源。
# 2.3.4 第四步,编写 Service
package cn.iocoder.yudao.module.infra.dsdemo;

import cn.iocoder.yudao.framework.common.pojo.PageParam;
import cn.iocoder.yudao.framework.common.pojo.PageResult;
import cn.iocoder.yudao.framework.mybatis.core.query.LambdaQueryWrapperX;
import com.baomidou.dynamic.datasource.annotation.DS;
import com.baomidou.dynamic.datasource.toolkit.DynamicDataSourceContextHolder;
import org.springframework.stereotype.Service;
import org.springframework.transaction.annotation.Transactional;

import jakarta.annotation.Resource; // JDK 8 版本的 master 分支,使用 javax.annotation.Resource

/**
 * 多数据源示例 Service
 *
 * @author 芋道源码
 */
@Service
public class DemoDataSourceService {

    @Resource
    private DemoOrderMapper demoOrderMapper;

    /**
     * 不切换:使用 primary 默认数据源,即 master
     */
    public String getDatabaseByDefault() {
        return demoOrderMapper.selectCurrentDatabase();
    }

    // ========== 方式一:@DS 注解 ==========

    @DS("demo")
    public String getDatabaseByAnnotation() {
        return demoOrderMapper.selectCurrentDatabase();
    }

    @DS("demo") // 先切换到 demo 数据源,再开启事务,所以是 demo 库的单库事务
    @Transactional(rollbackFor = Exception.class)
    public Long createOrder(String name) {
        DemoOrderDO order = new DemoOrderDO();
        order.setName(name);
        demoOrderMapper.insert(order);
        return order.getId();
    }

    @DS("demo") // 分页的 count 和列表查询,都在 demo 数据源中执行
    public PageResult<DemoOrderDO> getOrderPage(PageParam pageParam) {
        return demoOrderMapper.selectPage(pageParam, new LambdaQueryWrapperX<DemoOrderDO>()
                .orderByDesc(DemoOrderDO::getId));
    }

    // ========== 方式二:手动切换 ==========

    public String getDatabaseByManual(String dsName) {
        DynamicDataSourceContextHolder.push(dsName);
        try {
            return demoOrderMapper.selectCurrentDatabase();
        } finally {
            DynamicDataSourceContextHolder.poll();
        }
    }

}
# 2.3.5 第五步,验证效果
新增一个临时的 ApplicationRunner,在项目启动完成后,通过注入的 Spring Bean 调用上述方法:
package cn.iocoder.yudao.module.infra.dsdemo;

import cn.iocoder.yudao.framework.common.pojo.PageParam;
import cn.iocoder.yudao.framework.common.pojo.PageResult;
import lombok.extern.slf4j.Slf4j;
import org.springframework.boot.ApplicationArguments;
import org.springframework.boot.ApplicationRunner;
import org.springframework.stereotype.Component;

import jakarta.annotation.Resource; // JDK 8 版本的 master 分支,使用 javax.annotation.Resource

/**
 * 多数据源示例:启动后验证数据源切换,验证完成后删除
 *
 * @author 芋道源码
 */
@Component
@Slf4j
public class DemoDataSourceRunner implements ApplicationRunner {

    @Resource
    private DemoDataSourceService demoDataSourceService;

    @Override
    public void run(ApplicationArguments args) {
        log.info("[默认] database = {}", demoDataSourceService.getDatabaseByDefault());
        log.info("[注解] database = {}", demoDataSourceService.getDatabaseByAnnotation());
        log.info("[手动] database = {}", demoDataSourceService.getDatabaseByManual("demo"));
        log.info("[恢复] database = {}", demoDataSourceService.getDatabaseByDefault());
        Long id = demoDataSourceService.createOrder("多数据源示例");
        PageResult<DemoOrderDO> page = demoDataSourceService.getOrderPage(new PageParam());
        log.info("[分页] id = {}, total = {}, size = {}", id, page.getTotal(), page.getList().size());
    }

}
启动后端项目,预期的日志如下(首次执行时):
[默认] database = ruoyi-vue-pro
[注解] database = yudao-demo
[手动] database = yudao-demo
[恢复] database = ruoyi-vue-pro
[分页] id = 1, total = 1, size = 1
- 【注解】和【手动】都切换到了
yudao-demo库,并且调用结束后,恢复成了默认的ruoyi-vue-pro库。 - 新增的记录写入了
yudao-demo.demo_order表,而不是主库。 - 如果把
getDatabaseByManual("demo")改成一个不存在的名字,例如说demo2:strict: true时会抛出CannotFindDataSourceException异常;strict: false时会静默返回ruoyi-vue-pro。
验证完成后,记得删除 DemoDataSourceRunner 类,否则每次启动都会插入一条记录。
# 2.4 与分页插件结合
项目在 YudaoMybatisAutoConfiguration (opens new window) 中,已经注册了 MyBatis Plus 的 分页插件 (opens new window) PaginationInnerInterceptor,并且相关依赖都已经引入,无需重复注册。使用时注意如下几点:
① 项目注册分页插件时,没有指定 DbType 数据库类型。此时 MyBatis Plus 会根据当前连接的 JDBC URL,自动识别数据库类型,生成对应的分页 SQL。所以 master 是 MySQL、demo 是 PostgreSQL 这种混合的情况,也可以各自正确分页。不过,自动识别只解决分页语句的方言,表结构、JDBC 驱动、手写的 SQL 等,仍需要你按目标数据库进行适配。
不要把它改成 new PaginationInnerInterceptor(DbType.MYSQL) 这种写死的方式,否则非 MySQL 的数据源会生成错误的分页语句。
② 分页查询通常包含 count 总数、列表数据两类查询,需要将它们保留在同一次数据源切换的范围内。使用 selectPage 方法时,它们是在同一次 Mapper 调用中执行的,所以把 @DS 添加在包裹整个 selectPage 调用的方法上即可,参见上文的 getOrderPage 方法。
不要将 count 和列表拆开,分别在不同的数据源(或不同的从库)上查询,否则总数和列表可能对不上。
③ 不支持跨数据源的分页。一条 SQL 只会在一个数据源上执行,无法 JOIN 另一个数据源的表,也不会自动合并多个数据源的分页结果。如果确实需要,可以在业务代码中分别查询后再组装,或者通过数据同步、分库分表等方案解决。
# 3. 事务相关
事务一共有 3 种解决方案,分别是:
- 单机 + 单数据源:
@Transactional注解 - 单机 + 多数据源:
@DSTransactional注解 - 多机 + 单/多数据源:Seata 分布式事务
# 3.1 @Transactional 注解
大多数情况下,是单机 + 单个数据源的操作,只需要在方法上添加 Spring @Transactional 注解,声明事务即可。
具体的使用,可以项目里搜 @Transactional 关键字,就可以看到非常多的使用示例。
`@Transactional` 与 `@DS` 一起使用时:
Spring 开启事务时,会从数据源获取一个连接,并绑定到当前线程,整个事务内的 SQL 都复用这个连接。所以:
- 可以:在同一个方法上,同时添加
@DS("demo")和@Transactional注解(或者类上@DS、方法上@Transactional)。@DS切面的优先级更高,会先切换数据源、再开启事务,得到的是demo库的单库事务。例如说,上文的createOrder方法。 - 不可以:外层方法已经开启了
@Transactional事务(连接已绑定master),再调用带有@DS("demo")的内层方法,期望内层切换到demo库。此时内层的 SQL 依然使用外层master的连接,典型的报错是Table 'ruoyi-vue-pro.demo_order' doesn't exist。
# 3.2 @DSTransactional 注解
如果单机 + 多个数据源的操作,在 @Transactional 声明的事务中,无法进行数据源的切换(原因见上)。此时,可以使用 Dynamic Datasource 提供的 @DSTransactional (opens new window) 注解,支持多数据源的切换。
友情提示:
@DSTransactional 注解,提供相对可靠的多数据源的事务一致性,但是不绝对,可学习 《DSTransactional 实现源码分析 》 (opens new window) 文章。
使用的示例,AService 调用 BService、CService,并且分别对应 a、b、c 各自的数据源,代码如下所示:
@Service
public class AService {

    @Resource
    private BService bService;
    @Resource
    private CService cService;

    @DS("a") // 注意:如果 a 是默认数据源时,则不需要 @DS 注解
    @DSTransactional
    public void create() {
        // 调用 aMapper 逻辑
        bService.createB(); // 通过注入的 Spring Bean 调用,@DS 注解才会生效
        cService.createC();
    }

}

@Service
public class BService {

    @DS("b")
    public void createB() {
        // 调用 bMapper 逻辑
    }

}

@Service
public class CService {

    @DS("c")
    public void createC() {
        // 调用 cMapper 逻辑
    }

}
场景问题:
问题 ①:c 数据源的操作发生异常,a、b 数据源会回滚么?
- 答案:会的。
@DSTransactional会关闭 a、b、c 各自连接的自动提交,等到最外层AService#create()方法结束时才统一处理:正常返回,则逐个提交;抛出异常(默认rollbackFor = Exception.class),则逐个回滚。所以 a、b 已经执行的 SQL 尚未提交,会跟着一起回滚。 - 前提:异常需要抛出到
create()方法之外。如果在方法内try catch吞掉了异常,@DSTransactional会认为执行成功,进行提交。 - 注意:它不是 XA 两阶段提交。提交阶段是逐个数据源提交的,如果 a 提交成功后 b 提交失败(例如说网络中断),a 无法再回滚,就会出现数据不一致。对一致性要求很高的场景,可以考虑 Seata 分布式事务,或者设计补偿逻辑。
问题 ②:b、c 数据源的方法,也添加 @DSTransactional 注解,会不会影响事务?
- 答案:不会,可以放心大胆的加。默认的传播行为是
REQUIRED,内层会加入最外层的事务,统一提交或回滚。 - 注意:这条调用链上,不要再混用 Spring 的
@Transactional注解。外层是@Transactional时,连接已经绑定,后续的@DS不会再切换;内层是@Transactional时,在它的范围内也无法再切换数据源。
# 3.3 分布式事务
在多机分布式场景下,无论是单数据源、多数据源,本质上都是分布式事务,建议引入 Seata 框架,提供完整的分布式事务的解决方案,可学习 《芋道 Seata 极简入门 》 (opens new window) 文章。
不过如果你是单机项目,则可以不用关注着一点哈!
# 4. 分库分表
建议采用 ShardingSphere 的子项目 Sharding-JDBC 完成分库分表的功能,可阅读 《芋道 Spring Boot 分库分表入门 》 (opens new window) 文章,学习如何整合进项目。
# 5. 常见问题排查
排查前,建议先在 application-local.yaml 中开启如下日志,可以看到每次获取连接时切换到了哪个数据源,以及事务的开启、提交、回滚:
logging:
  level:
    com.baomidou.dynamic.datasource: debug # 数据源切换、@DSTransactional 事务的日志
    org.springframework.jdbc: debug # Spring @Transactional 事务的日志
其中,dynamic-datasource switch to the datasource named [xxx] 日志,只在获取新连接时打印。如果处于 Spring 事务中、复用了已绑定的连接,是看不到这条日志的。
# 5.1 数据源找不到、切换不生效
① 确认数据源已经注册:启动日志中,搜索 dynamic-datasource - add a datasource named [xxx] success,并确认 @DS 中的名字与配置完全一致(包括大小写、下划线)。
② 注意,在 [基础设施 -> 数据源配置] 菜单中新增的记录,主要用于代码生成等功能,不会自动注册成 @DS 可以使用的数据源。如果需要,得自行编写代码注册,例如说 《SaaS 多租户【数据库隔离】》 的实现。
③ 开启 strict: true 严格模式(参见《2.3.2 第二步,配置数据源》),让“找不到数据源”从静默回落主库,变成抛出 CannotFindDataSourceException 异常。
④ 确认 @DS 注解被 Spring AOP 拦截到了:
- 必须是 Spring Bean,并且通过注入的 Bean 调用。
new出来的对象、this.xxx()同类内部的自调用,都不会触发注解。 - 必须是
public方法,非public方法上的@DS默认会被忽略。 - 如果 Mapper 接口上也有
@DS,执行 SQL 时以 Mapper 上的为准(参见《2.2.3 @DS 注解》小节)。
⑤ 确认没有处于 Spring @Transactional 事务中(参见《3.1 @Transactional 注解》小节)。外层已经开启事务时,内层的 @DS、手动切换都不会生效。
⑥ 确认没有在其它线程中执行。@Async 异步方法、线程池、parallelStream 等不会继承当前线程的数据源和 @DSTransactional 事务。需要在异步任务内部,通过注入的 Bean 调用带有 @DS 的方法,或者手动 push + poll 切换。
⑦ 最后,以“实际连接”为准进行验证。DynamicDataSourceContextHolder.peek() 只能看到当前想要切换的数据源名字,不代表实际使用的连接已经切换过去(例如说,回落主库、已绑定事务连接的情况)。可以参考《2.3 完整示例》,执行 SELECT DATABASE()(MySQL)或者 SELECT current_database()(PostgreSQL)查看当前的库名,也可以打印 JDBC DatabaseMetaData 中的 URL。注意,不要把账号密码打印到日志中。
# 5.2 事务不生效、没有回滚
① 确认事务注解被 Spring AOP 拦截到了,规则和上面的 @DS 类似:必须是 Spring Bean,并且通过注入的 Bean 调用,this.xxx() 自调用不生效;注解统一加在 public 方法上(@DSTransactional 默认只对 public 方法生效)。
② 确认异常抛出到了事务方法之外,而不是被 try catch 吞掉。另外,Spring @Transactional 默认只对 RuntimeException 和 Error 回滚,项目里统一使用 @Transactional(rollbackFor = Exception.class) 写法;@DSTransactional 默认是 rollbackFor = Exception.class。
③ 跨多个数据源时,在最外层方法上使用 @DSTransactional,并且调用链上不要混用 @Transactional(参见《3.2 @DSTransactional 注解》小节)。
④ 确认没有使用 REQUIRES_NEW 传播行为(无论是 Spring 的 Propagation.REQUIRES_NEW,还是 @DSTransactional 的 DsPropagation.REQUIRES_NEW)。它是一个独立的事务,会自己提交,外层回滚时它不会跟着回滚,也不提供跨库的原子性。
⑤ 确认没有在其它线程中执行,原因同 5.1 小节。
⑥ 确认表的存储引擎支持事务。例如说,MySQL 的 MyISAM 引擎不支持事务,需要使用 InnoDB 引擎。
⑦ 如果出现“部分数据源提交了、部分没有”,先查看上文开启的事务日志,确认各数据源的提交、回滚情况。可能的原因之一,是 @DSTransactional 在逐个数据源提交时某个数据源失败了,它不是 XA 两阶段提交,无法保证绝对一致(参见《3.2 @DSTransactional 注解》小节);同时也要结合上面的异常被吞掉、REQUIRES_NEW 独立事务等情况一起排查。