
 请求日志与 Token 用量
AI 请求日志,记录 AI 对话、AI 写作、AI 思维导图 每次调用大模型的情况,包括 Token 用量、状态、耗时等等,方便统计 Token 的消耗、排查调用失败的原因。
整个功能,涉及到 4 个表:
- 【日志】
ai_request_log:AI 请求日志表 - 【业务】
ai_chat_message:聊天消息表,见 《AI 对话聊天》 - 【业务】
ai_write:写作表,见 《AI 写作助手》 - 【业务】
ai_mind_map:思维导图表,见 《AI 思维导图》
# 1. 请求日志表
每次生成(一次聊天回复、一次写作、一次思维导图生成)结束时,不管成功、失败还是取消,都会记录一条请求日志。
# 1.1 表结构
省略 creator/create_time/updater/update_time/deleted 等通用字段
CREATE TABLE `ai_request_log` (
  `id` bigint NOT NULL AUTO_INCREMENT COMMENT '编号',
  `request_id` varchar(64) COLLATE utf8mb4_unicode_ci NOT NULL COMMENT '本地请求 UUID',
  `user_id` bigint DEFAULT NULL COMMENT '用户编号',

  `biz_type` int NOT NULL COMMENT '业务类型 1聊天 2写作 3思维导图',
  `biz_id` bigint DEFAULT NULL COMMENT '业务编号',

  `platform` varchar(64) COLLATE utf8mb4_unicode_ci DEFAULT NULL COMMENT '模型平台快照',
  `model_id` bigint DEFAULT NULL COMMENT '模型编号',
  `model` varchar(255) COLLATE utf8mb4_unicode_ci DEFAULT NULL COMMENT '模型标识快照',

  `status` int NOT NULL COMMENT '状态 20成功 30失败 40取消',
  `error_message` text COLLATE utf8mb4_unicode_ci COMMENT '异常信息',
  `begin_time` datetime(3) NOT NULL COMMENT '开始时间',
  `end_time` datetime(3) NOT NULL COMMENT '结束时间',
  `duration` bigint NOT NULL COMMENT '耗时毫秒',

  `input_tokens` bigint DEFAULT NULL COMMENT '实际输入 Token,未知为空',
  `output_tokens` bigint DEFAULT NULL COMMENT '实际输出 Token,未知为空',
  `total_tokens` bigint DEFAULT NULL COMMENT '实际合计 Token,未知为空',
  `response_metadata` json DEFAULT NULL COMMENT '响应元数据快照,包含原生用量',
  `tenant_id` bigint NOT NULL DEFAULT '0' COMMENT '租户编号',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_request_id` (`request_id`),
  KEY `idx_tenant_begin_time` (`tenant_id`,`begin_time`),
  KEY `idx_tenant_user_begin_time` (`tenant_id`,`user_id`,`begin_time`),
  KEY `idx_tenant_biz` (`tenant_id`,`biz_type`,`biz_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci COMMENT='AI 请求日志';
① request_id 字段:请求编号,调用模型前由服务端生成的 UUID,和模型平台响应里的 id 不是一个东西。业务表通过 request_id 字段,关联到对应的请求日志。
user_id 字段:对应 system_users 表的 id 字段,表示哪个用户发起的请求。
② biz_type 字段:业务类型,对应 AiRequestLogBizTypeEnum 枚举,目前有 1 聊天、2 写作、3 思维导图。
biz_id 字段:业务编号。聊天时对应 ai_chat_message 表的模型回复消息,写作时对应 ai_write 表,思维导图时对应 ai_mind_map 表。
③ platform、model_id、model 字段:调用时的模型平台、模型编号、模型标识。之后模型配置被修改,也不影响已记录的日志。
④ status 字段:请求状态,对应 AiRequestLogStatusEnum 枚举,目前有 20 成功、30 失败、40 取消(例如说用户停止了流式生成)。失败时,error_message 字段记录错误信息。
begin_time、end_time、duration 字段:开始时间、结束时间、耗时(毫秒)。
⑤ input_tokens、output_tokens、total_tokens 字段:输入、输出、合计 Token 数,来自模型平台的返回,没有返回时为空。total_tokens 只在输入、输出都有值时,才会计算。
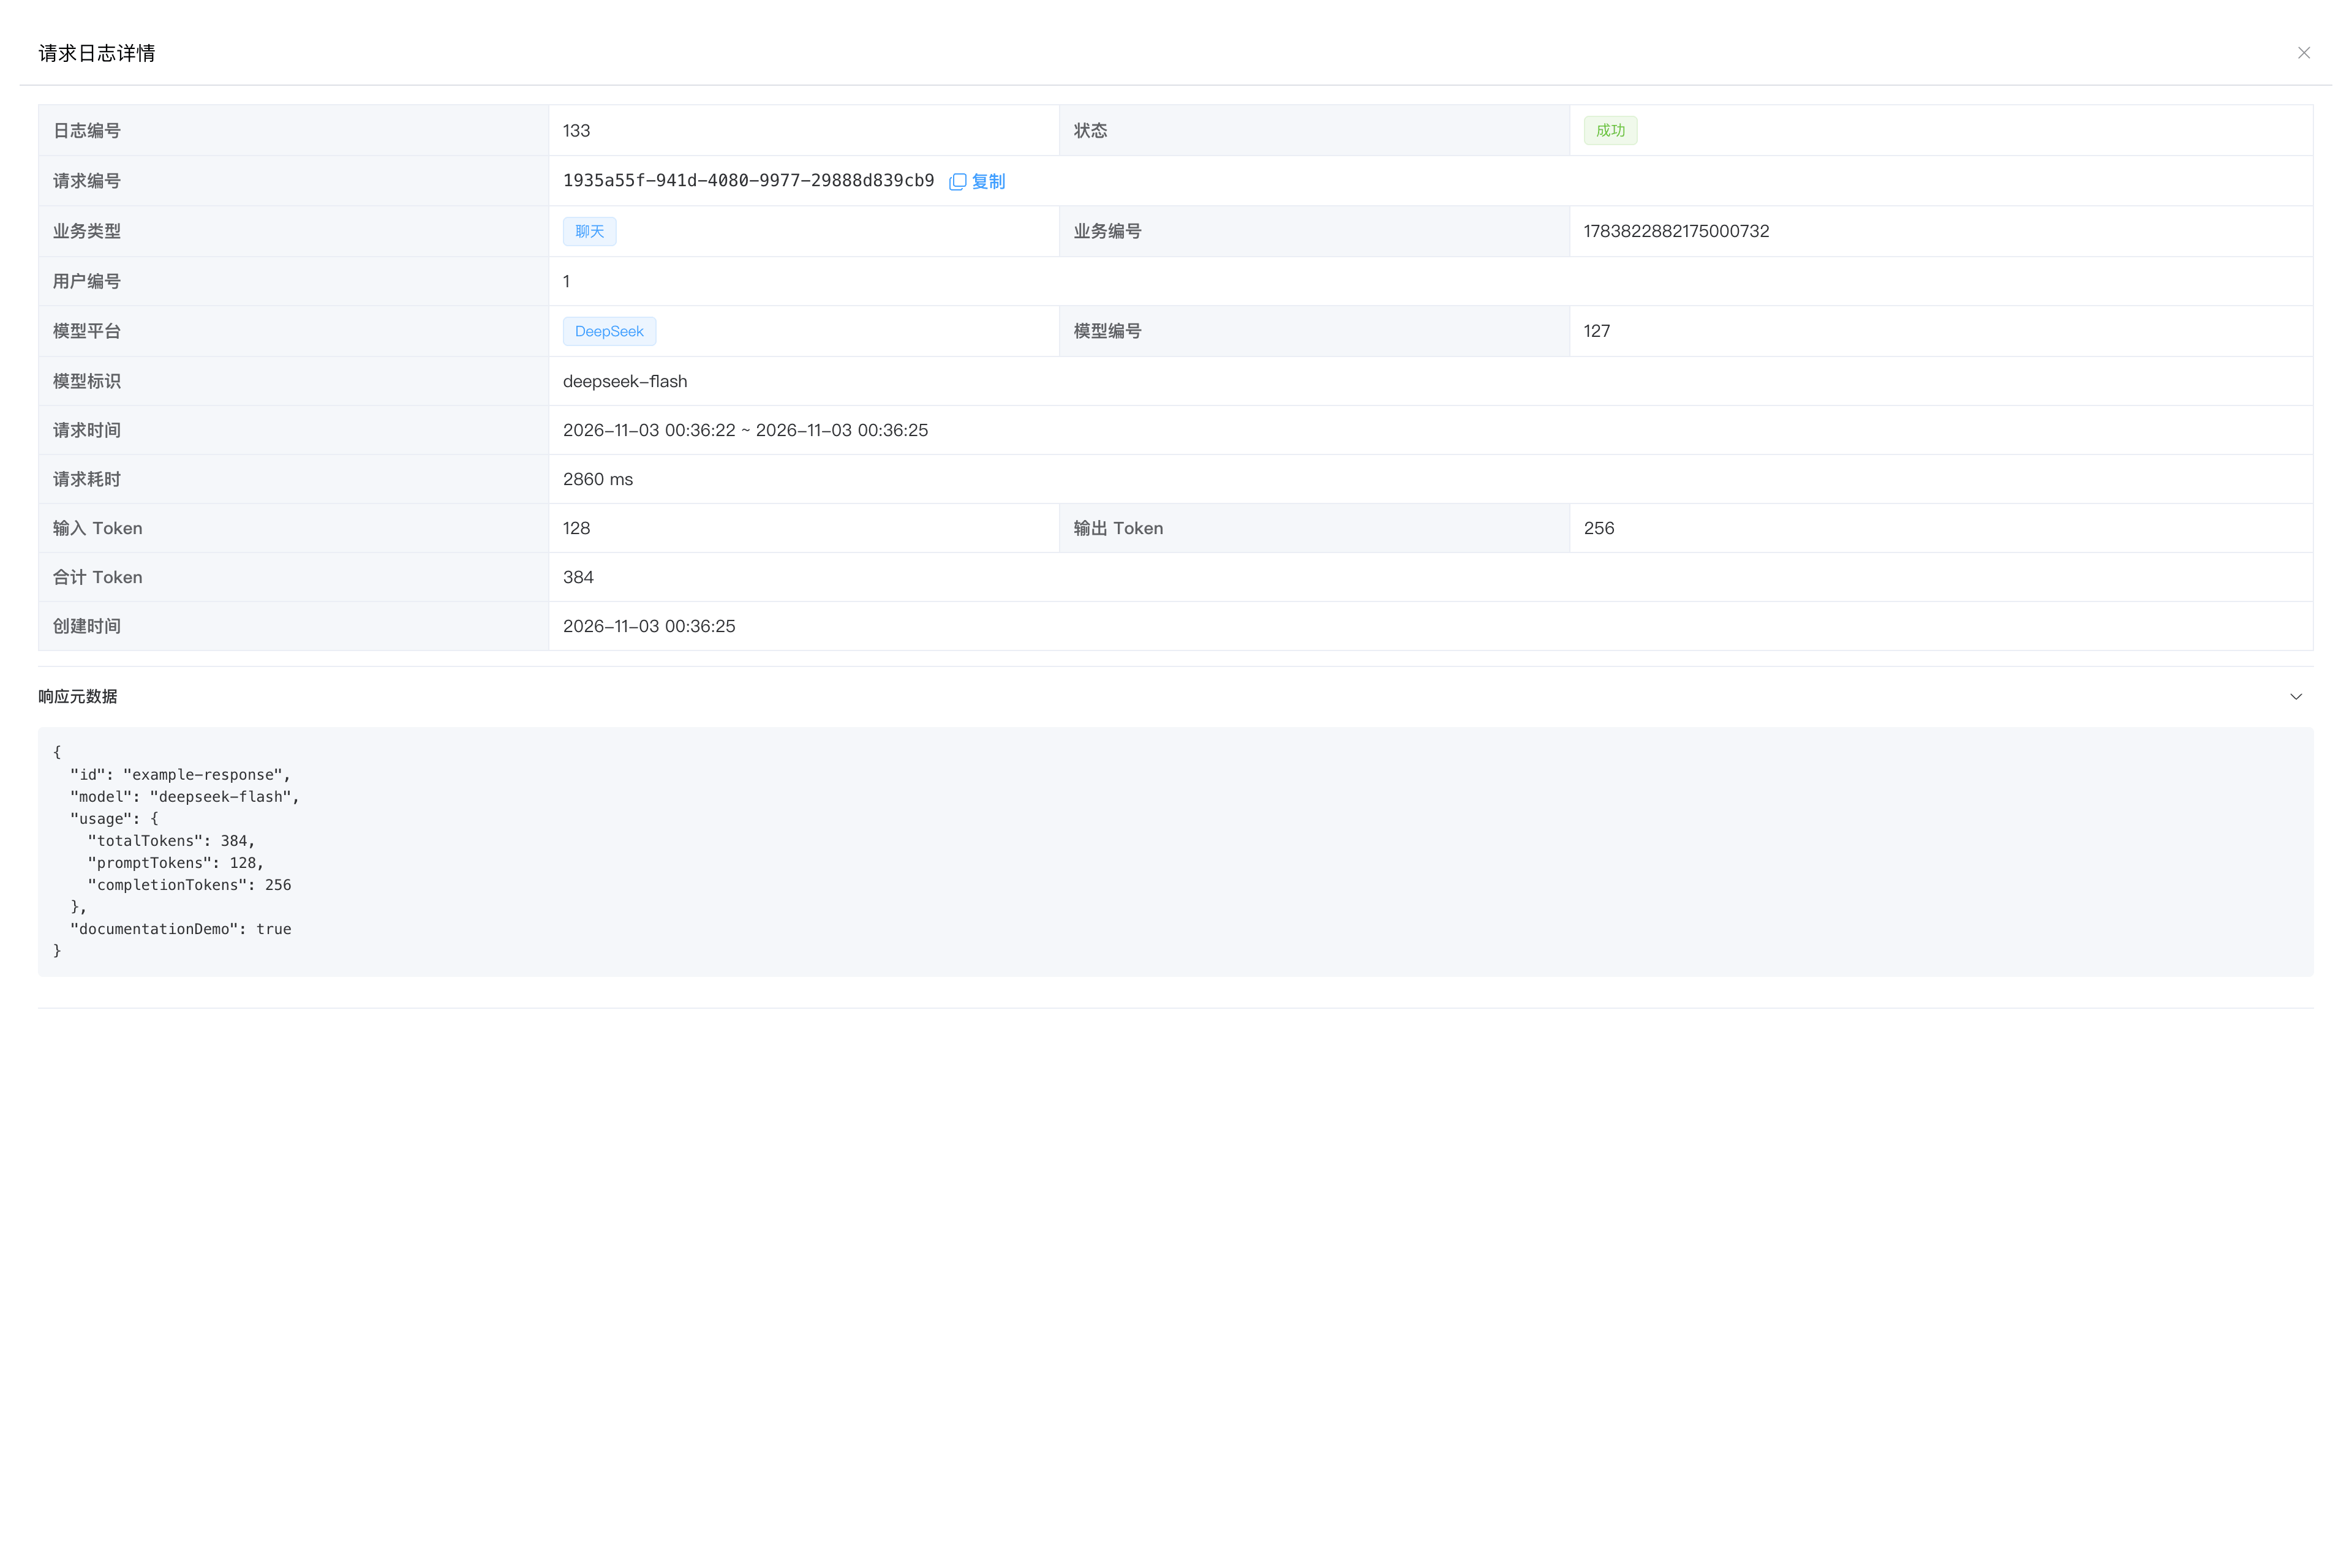
response_metadata 字段:响应元数据,JSON 格式,记录模型平台返回的 id、model、usage(含平台原生用量)等信息,方便排查问题。
⑥ tenant_id 字段:租户编号。表结构里保留它,是因为几个索引都以它开头,按租户查询、统计请求日志。
注意,请求日志不记录提示词、生成内容,它们还是在对应的业务表里。
# 1.2 管理后台
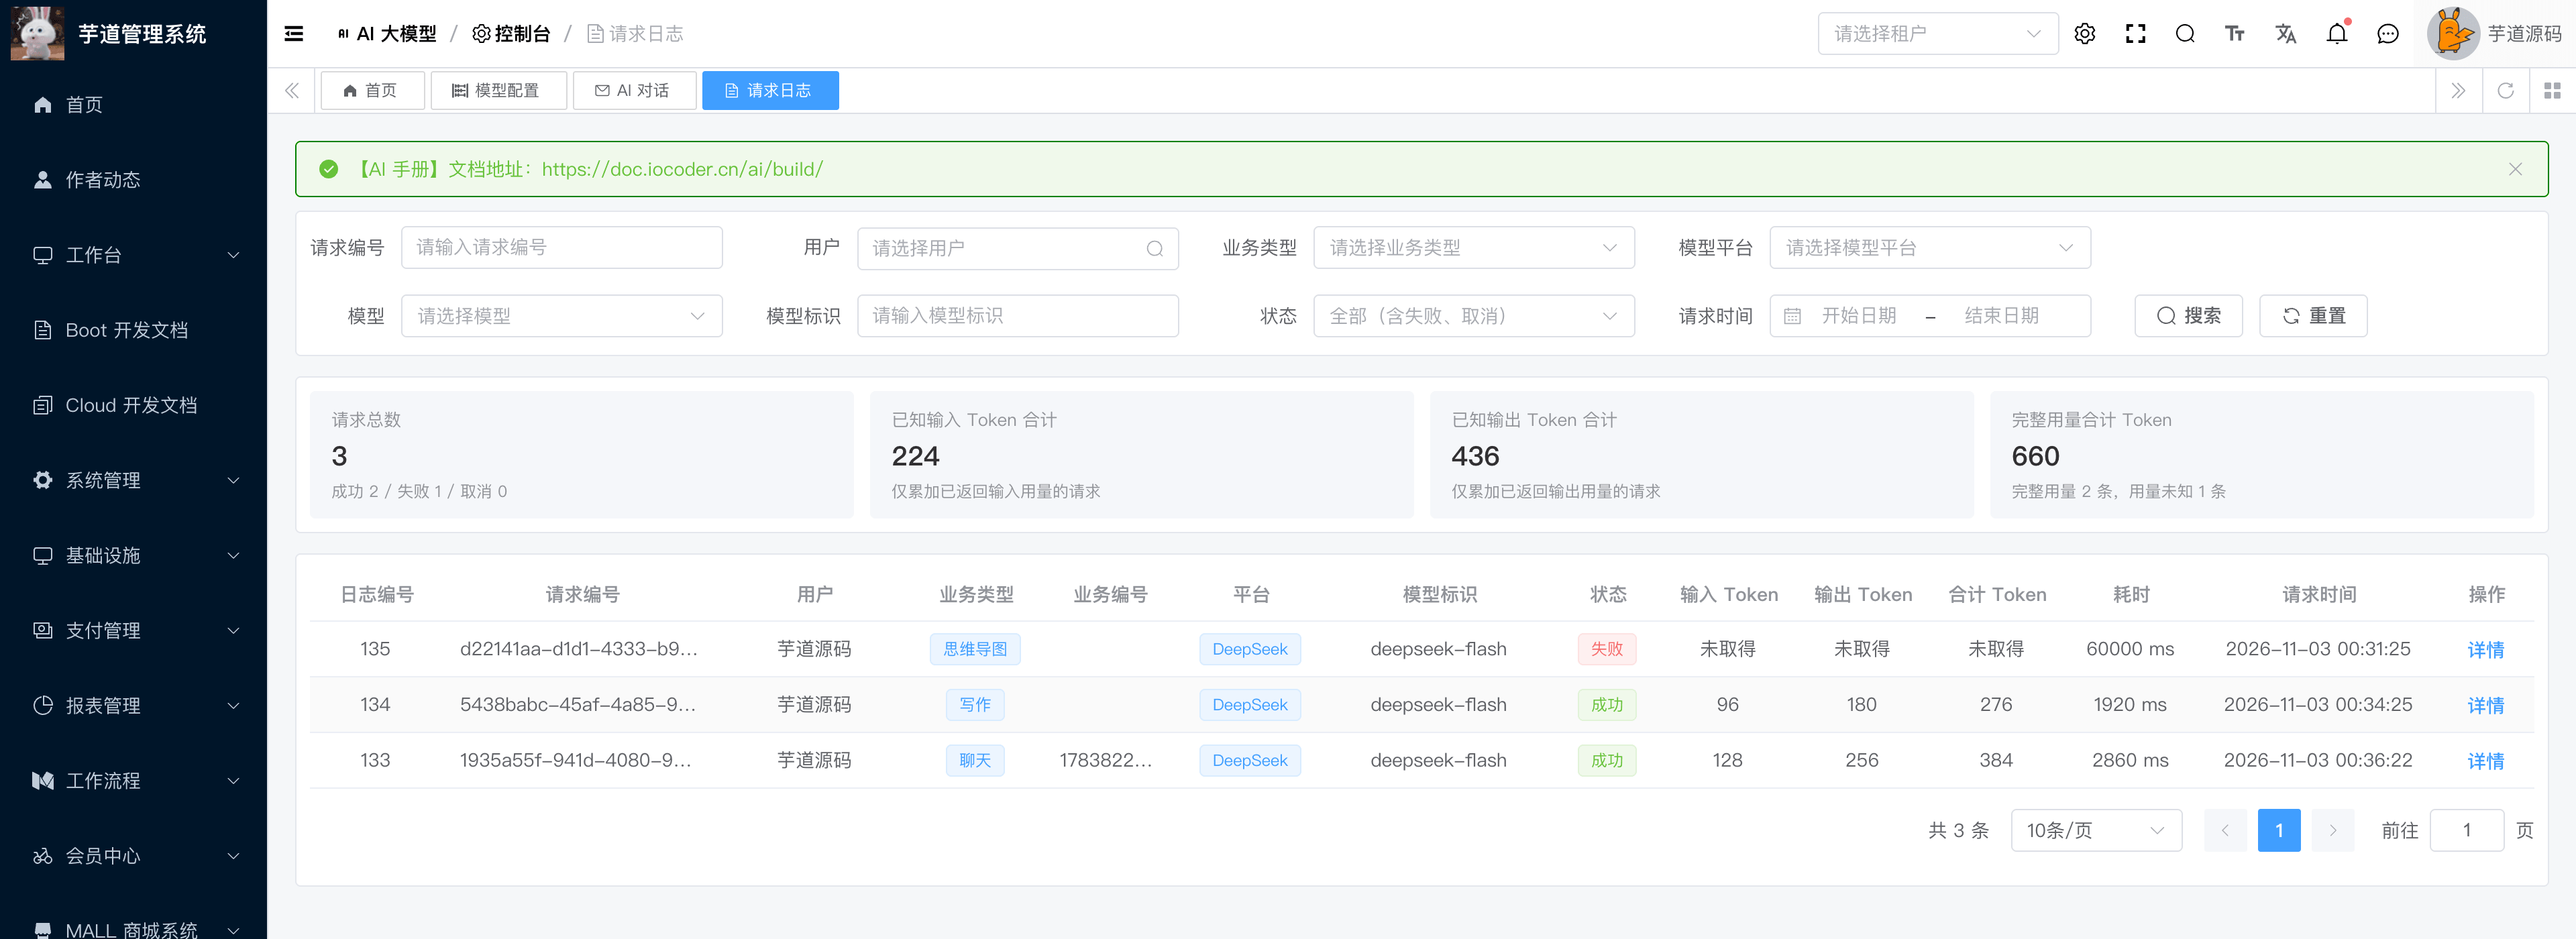
前端对应 [AI 大模型 -> 控制台 -> 请求日志] 菜单,对应 yudao-ui-admin-vue3 项目的 @/views/ai/requestlog 目录,提供给管理员使用,查看请求日志、统计 Token 用量。
① 列表上方,会统计符合搜索条件的全部请求:请求数(成功、失败、取消),以及输入、输出、合计 Token 数。没有取得的用量,不计入 Token 合计。
② 点击【详情】按钮,可以查看单条请求日志,包括「响应元数据」。如下图所示:
例如说,使用 《小米 MiMo》 后,可以按「模型平台」筛选 MiMo,再按「模型标识」查询某个型号的请求和 Token 用量。
它的后端 HTTP 接口,由 yudao-module-ai 模块的 requestlog 包的 AiRequestLogController 实现。
最关键的代码!
请求日志的记录,由 AiRequestLogService 实现:调用模型前,通过 #buildCreateReqDTO(...) 方法创建快照;生成过程中,通过 #setCreateReqDTO(...) 方法设置 Token 用量;生成结束后,通过 #createRequestLog(...) 方法写入数据库。
对应的调用,可见 AiChatMessageServiceImpl、AiWriteServiceImpl、AiMindMapServiceImpl 类。
# 2. Token 用量
ai_chat_message、ai_write、ai_mind_map 表,都有 request_id、input_tokens、output_tokens、total_tokens 字段,记录本次生成的请求编号、Token 用量,和请求日志里的一致。
在 [AI 大模型 -> AI 对话] 菜单,每条模型回复的下方,会展示本次的 Token 用量。如下图所示:
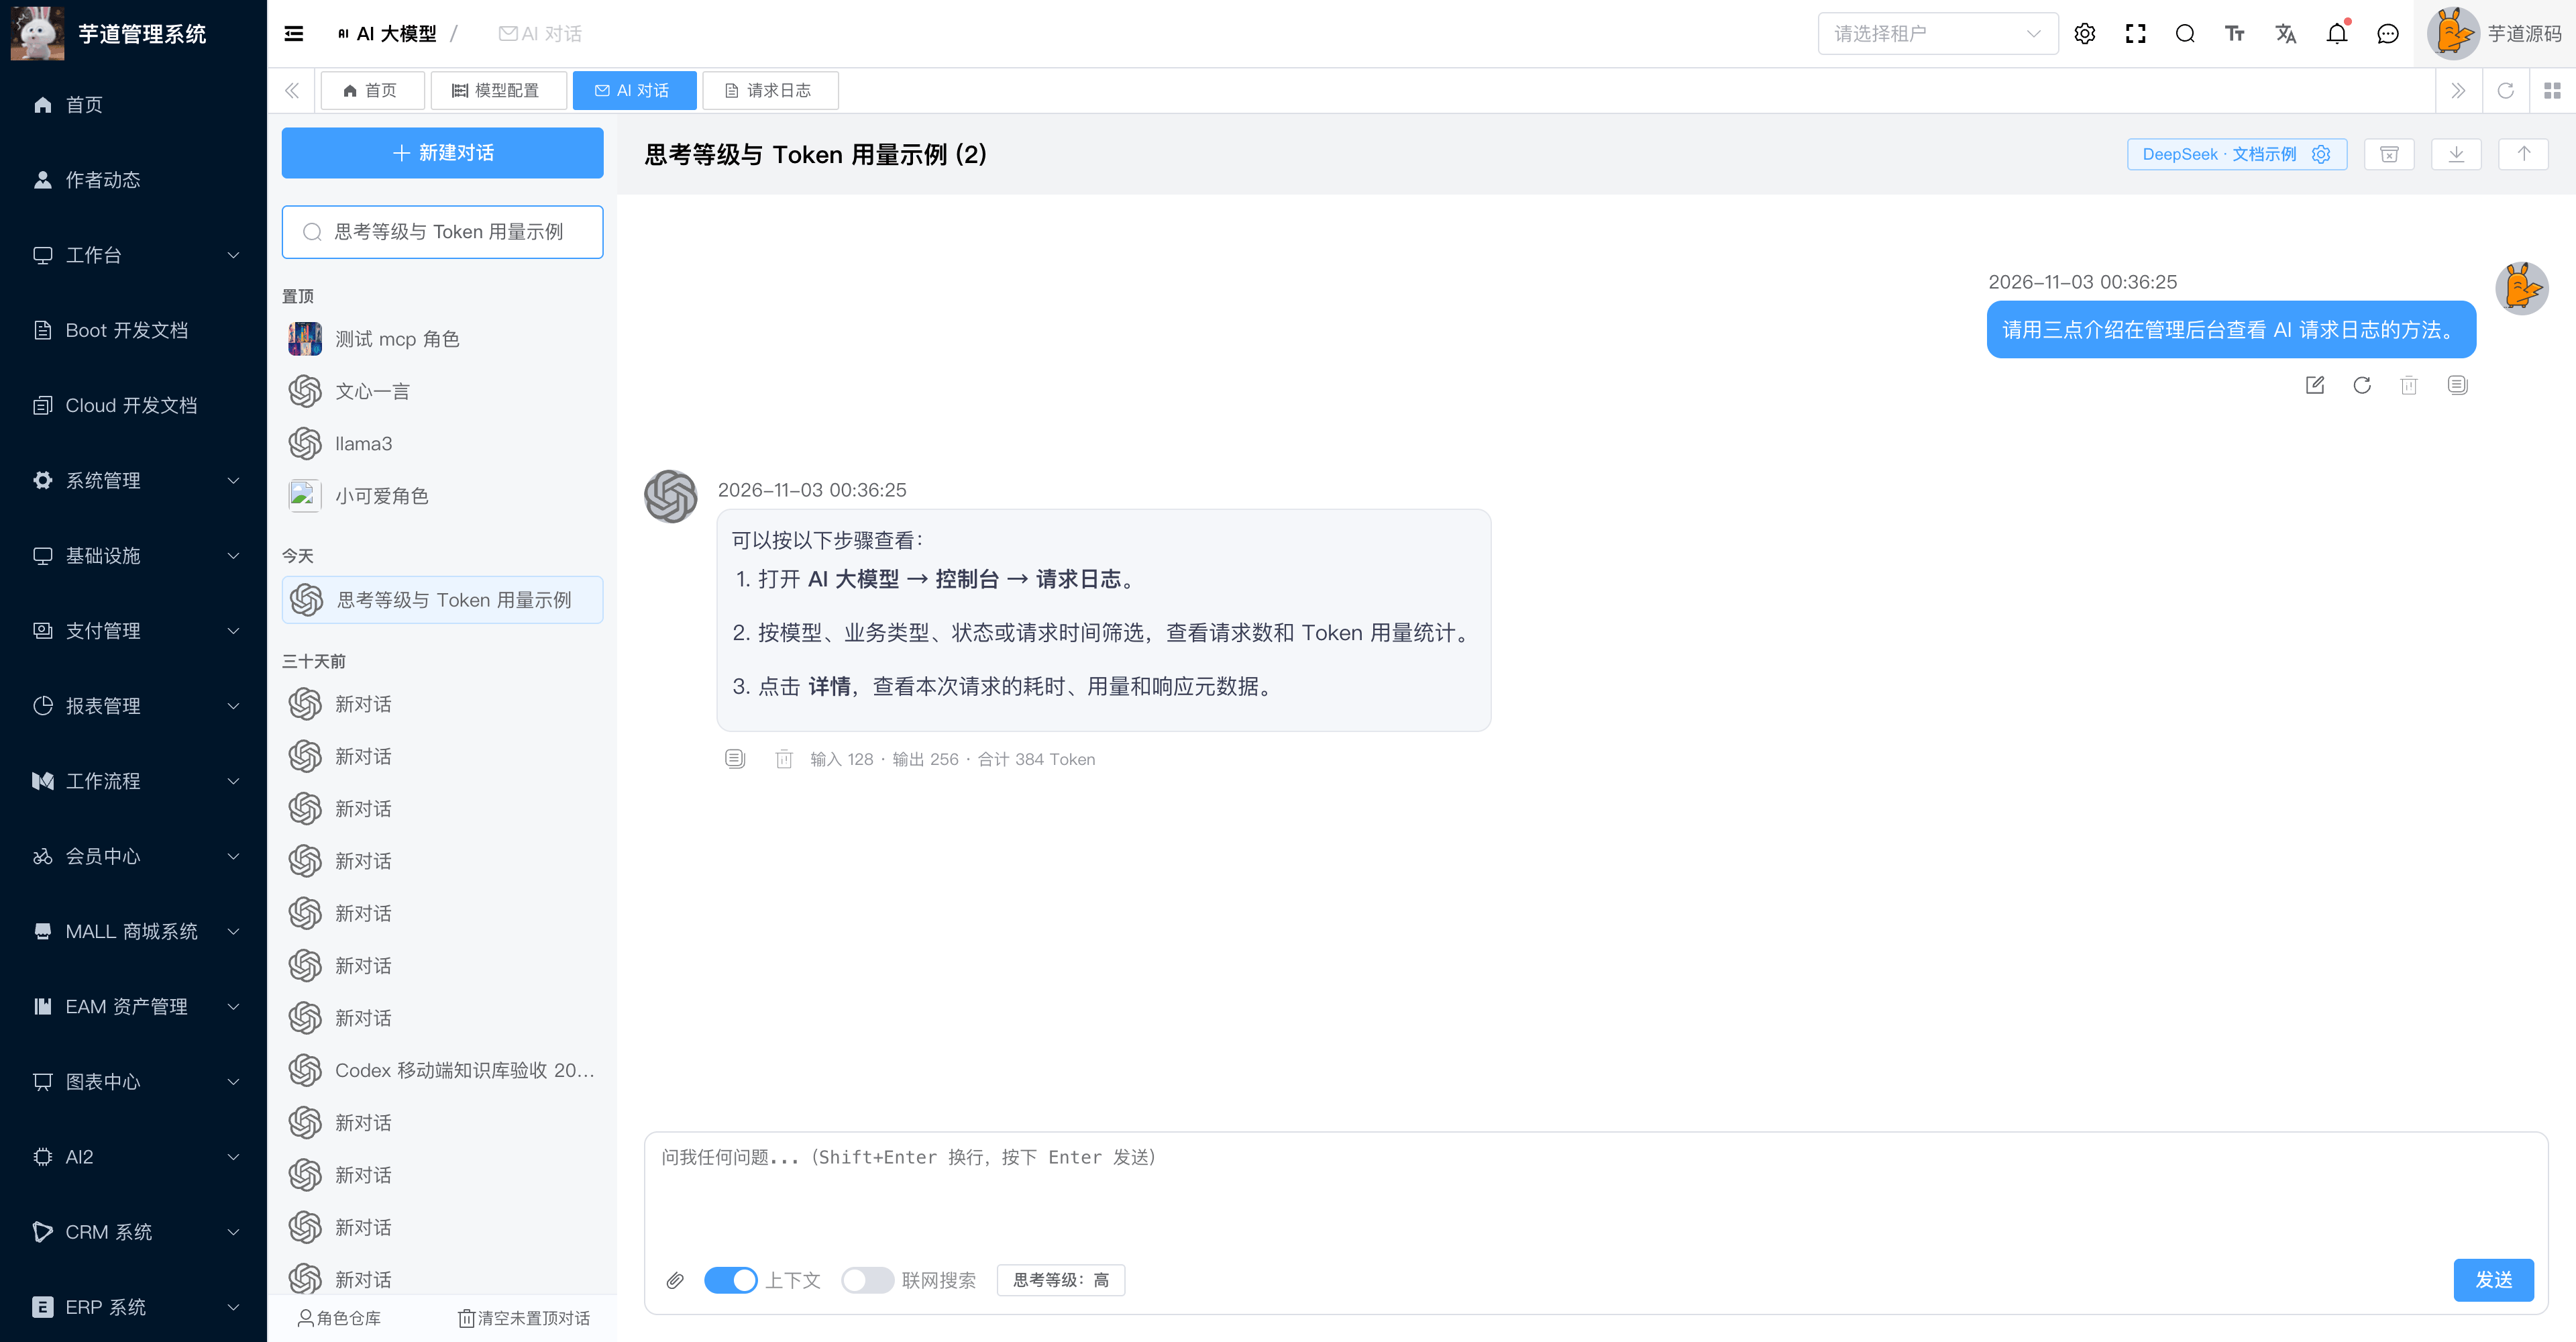
AI 写作、AI 思维导图的生成结果,以及 [AI 大模型 -> 控制台] 下的聊天管理、写作管理、导图管理,也都会展示 Token 用量。模型平台没有返回用量时,展示为「未取得」。
# 666. 社区贡献相关
- 《Pull Request:AI Token 统计、调用日志与预算计费》:后端代码 (opens new window)、前端代码 (opens new window)